

Trong phần này, chúng tôi sẽ giới thiệu hai công cụ thu thập nội dung web đơn giản: Công cụ tải nội dung web và Công cụ chụp ảnh màn hình web. Các công cụ này được phát triển để tạo điều kiện thuận lợi cho việc thu thập dữ liệu web, có thể được sử dụng trong các dự án dữ liệu lớn khác nhau. Ngoài ra, chúng ta sẽ khám phá một trường hợp sử dụng trong đó các công cụ này được sử dụng để xác minh hàng loạt trang web lừa đảo.
# Author:      Yuancheng Liu
# Created:     2024/09/10
# Version:     v_0.2.1
# Copyright:   Copyright (c) 2025 Liu Yuancheng
----------------------------------------------------------------------------------------------------
Công cụ tải nội dung Web Python
Mục đích thiết kế chương trình: Mục tiêu của chúng tôi là phát triển một thư viện Python phù hợp cho các dự án dữ liệu lớn, được thiết kế đặc biệt cho mục đích thu thập dữ liệu. Thư viện này sẽ tạo điều kiện thuận lợi cho việc thu thập và tải xuống tất cả các thành phần liên quan đến nhiều lô trang web, bao gồm các tệp .html, biểu định kiểu .css, hình ảnh, tệp XML, video, tệp JavaScript và chứng chỉ SSL của máy chủ, dựa trên danh sách URL được cung cấp.
Quy trình làm việc của chương trình được mô tả dưới đây:

Giới thiệu
Mô-đun này cung cấp một API để tải xuống các thành phần khác nhau của trang web, bao gồm các tệp HTML, hình ảnh, tệp CSS, tệp XML, tệp JavaScript và các liên kết siêu văn bản, dựa trên các URL đầu vào (phải bắt đầu bằng 'http' hoặc 'https'). Luồng đầu vào và đầu ra của mô-đun được thể hiện trong sơ đồ dưới đây:

Thư viện sẽ tải xuống nội dung html chính của web trước, sau đó sử dụng thư viện python beautifulsoup để phân tích cú pháp tất cả nội dung từ nguồn tệp html web để lấy html, hình ảnh, java script, css được liên kết, sau đó tải xuống nội dung từng cái một và lưu trong thư mục cục bộ liên quan. Nó sẽ cung cấp một API linh hoạt cho phép tích hợp với các chương trình khác một cách liền mạch.
Cách sử dụng chương trình
Người dùng có hai tùy chọn để thực thi chương trình: xử lý các URL riêng lẻ hoặc xử lý hàng loạt nhiều URL.
Sử dụng giao diện Console
Để xử lý các URL riêng lẻ, người dùng có thể chạy trực tiếp chương trình và làm theo các bước được cung cấp:
python webDownload.py
Xử lý hàng loạt URL với tệp bản ghi
Bước 1: Chuẩn bị danh sách các URL sẽ được xử lý bằng cách sao chép chúng vào tệp bản ghi URL "urllist.txt".
Bước 2: Điều hướng đến thư mục chương trình và thực thi chương trình bằng lệnh sau: python testCase.py
Bước 3 Kiểm tra kết quả:
Ví dụ: nếu bạn sao chép url "https://www.carousell.sg/" làm url đầu tiên bạn muốn kiểm tra vào tệp "urllist.txt", tất cả các tệp html, tệp hình ảnh và tệp js sẽ nằm trong thư mục "`1_www.carousell.sg_files`"
- Trang web chính sẽ được lưu thành: "`1_www.carousell.sg_files/1_www.carousell.sg.html`"
- Hình ảnh được sử dụng trong trang sẽ được lưu trong thư mục: "`1_www.carousell.sg_files/img`"
- Html/imge/css được nhập bởi href sẽ được lưu trong thư mục: "`1_www.carousell.sg_files/link`"
- Tệp js được sử dụng bởi trang sẽ được lưu trong thư mục: "`1_www.carousell.sg_files/script`"
- Chuỗi url https://www.carousell.sg/ sẽ được lưu trong tệp 1_www.carousell.sg_files/Info.txt.
- Chứng chỉ của máy chủ www.carousell sẽ được tải xuống dưới dạng tệp 1_www.carousell.sg_files/cert/cert.der.
Liên kết Repo GitHub của dự án : https://github.com/LiuYuancheng/Py_Web_Contents_Download_Tool
----------------------------------------------------------------------------------------------------
Công cụ chụp ảnh màn hình Web Python
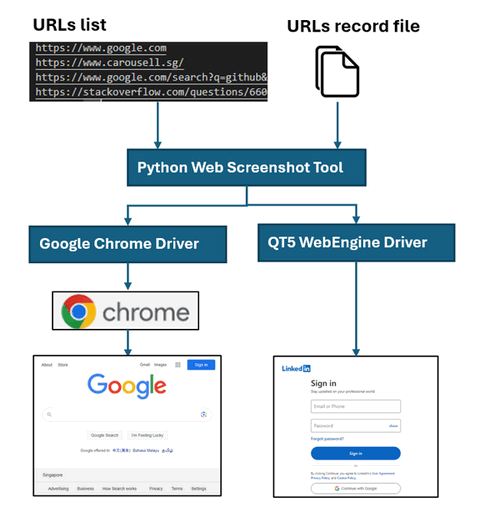
Mục đích thiết kế chương trình: Mục tiêu của chúng tôi là phát triển một thư viện Python cho mục đích thu thập dữ liệu của dự án bigdata, có thể chụp ảnh màn hình trang web hàng loạt, dựa trên danh sách URL, để hỗ trợ các trường hợp sử dụng theo chương trình khác nhau. Quy trình làm việc của chương trình được mô tả dưới đây:
Giới thiệu
Mô-đun này cho phép người dùng chụp ảnh màn hình của các phần cụ thể hoặc toàn bộ trang web bằng các trình điều khiển trình duyệt web khác nhau hoặc QtWebEngineWidgets của thư viện Qt5, dựa trên URL được cung cấp. Người dùng có thể chọn thư viện mong muốn để chụp trang web trong quá trình khởi tạo đối tượng bằng cách chỉ định tham số "driverMode". Mô-đun hoạt động như một chương trình đơn luồng. Luồng đầu vào và đầu ra của mô-đun được hiển thị bên dưới:

Thư viện sử dụng hai trình điều khiển web khác nhau, Selenium Google Chrome Driver và QT5 Web Engine, để chụp ảnh màn hình trang web. Nó cung cấp một API linh hoạt cho phép tích hợp với các chương trình khác một cách liền mạch.
Để xử lý đồng thời nhiều URL, người dùng có thể liệt kê tất cả các URL họ muốn chụp trong tệp "urllist.txt" như minh họa bên dưới (dòng bắt đầu bằng ký tự '#' sẽ được coi là nhận xét và bị bỏ qua) :
# Add the URL you want to download line by line(The url must start with 'http' or 'https' ):
# example: https://www.google.com
https://www.google.com
https://www.carousell.sg/
https://www.google.com/search?q=github&sxsrf=AOaemvJh3t5_h8H85AE8Ajbb1IMnBrRISA%3A1636698503535&source=hp&ei=hwmOYY6mHdGkqtsPq8S9sAY&iflsig=ALs
Sau đó, thực thi chương trình test case testCase.py và ảnh chụp màn hình đã chụp sẽ được lưu trong thư mục đầu ra outputFolder.
Cách sử dụng chương trình
Người dùng có hai tùy chọn để thực thi chương trình: xử lý các URL riêng lẻ hoặc xử lý hàng loạt nhiều URL. Tất cả các tệp hình ảnh chụp màn hình sẽ được lưu trong thư mục đầu ra outputFolder theo định dạng shot_yymmdd_hhmmss.png.
Sử dụng giao diện Console
Để xử lý các URL riêng lẻ, người dùng có thể chạy trực tiếp chương trình và làm theo các bước được cung cấp:
python webScreenShoter.py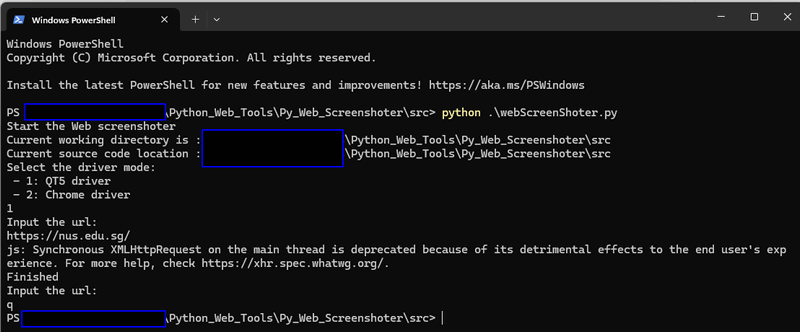
Xử lý hàng loạt URL với tệp bản ghi
Chuẩn bị danh sách các URL sẽ được xử lý bằng cách sao chép chúng vào tệp bản ghi URL "urllist.txt".
Điều hướng đến thư mục chương trình và thực thi chương trình bằng lệnh sau: python testCase.py
Kiểm tra kết quả: ví dụ: nếu "https://www.carousell.sg/" là URL đầu tiên được liệt kê trong "urllist.txt", tệp ảnh chụp màn hình shot.png sẽ được lưu trong thư mục "1_www.carousell.sg_files".
Liên kết Repo GitHub của dự án :
https://github.com/LiuYuancheng/Py_Web_Screenshot_Capture_Tool
----------------------------------------------------------------------------------------------------
Trường hợp sử dụng: Công cụ chứng thực Web Python
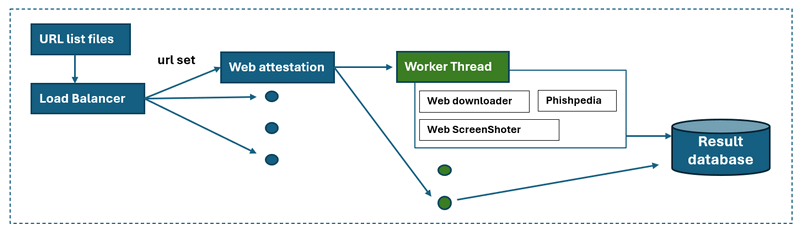
Mục đích thiết kế chương trình: Chúng tôi muốn tạo một công cụ tự động để kiểm tra một số lô URL web (từ 1 đến 10.000) và xác định các trang web/URL lừa đảo trong số đó. Chương trình sẽ tải xuống nội dung web từ danh sách URL đã cho, sau đó chụp ảnh màn hình của trang web và đưa tất cả dữ liệu vào chương trình Phishperida. Quy trình làm việc của chương trình được mô tả dưới đây:

Dự án sẽ tận dụng dự án NUS-Phishperida, được phát triển bởi Prof. Yun Lin và Ruofan Liu, để xác định trang web lừa đảo. Ngoài ra, nó sẽ sử dụng Py_Web_Screenshot_Capture_Tool và Py_Web_Contents_Download_Tool để lưu trữ nội dung web tự động.
Giới thiệu
Mô-đun này được tạo ra để chứng thực URL/web bằng API do Dự án NUS-Phishperida cung cấp. Nó bao gồm bốn mô-đun chính:
- DatasetLoader: Chịu trách nhiệm tải dữ liệu URL từ các tệp cấu hình theo lô và lọc các URL đã xử lý.
- WebDownloader: Tạo điều kiện thuận lợi cho việc thu thập và tải xuống các thành phần trang web.
- WebScreenShoter: Chụp ảnh màn hình trang web.
- PhishperidaPKG: Một mô-đun trình bao bọc để gọi thư viện Phishperida và ghi lại kết quả xác minh.
Đối với mỗi URL, chương trình trải qua các bước sau:
- Sử dụng mô-đun WebDownloader để tải xuống tất cả các thành phần trang web.
- Sử dụng mô-đun webScreenShoter để chụp ảnh màn hình trang web.
- Chuyển các thành phần trang web và ảnh chụp màn hình đến PhishperidaPKG để kiểm tra siamese.
Mô-đun DatasetLoader
- Mô-đun này tải dữ liệu URL từ danh sách URL, ghi lại các URL đã xử lý và các URL lỗi. Trong trường hợp chương trình/luồng bị treo, nó sẽ tiếp tục nhiệm vụ khi khởi động lại, bỏ qua các URL đã xử lý và xóa các tệp bị hỏng trước khi tiếp tục với các URL chưa xử lý.
Mô-đun WebDownloader
- Tham khảo Công cụ tải nội dung Web Python trước đó
Mô-đun WebScreenShoter
- Tham khảo Công cụ chụp ảnh màn hình Web Python trước đó
Mô-đun PhishperidaPKG
- Mô-đun này được sử dụng để đóng gói dự án NUS-Phishperida (không phải OOP) như một API hộp đen để các dự án khác sử dụng.
- Liên kết Repo Github của dự án NUS-Phishperida : https://github.com/lindsey98/Phishpedia
Thiết kế đa luồng
Sử dụng đa luồng với bộ điều khiển thực thi nền, thực thi đa luồng, bộ cân bằng tác vụ:
Cách sử dụng chương trình
Sao chép url bạn muốn kiểm tra trong tệp bản ghi url "urllist.txt"
Cd đến thư mục chương trình và chạy cmd thực thi chương trình:
python webAttestation.pyKiểm tra kết quả xử lý trong tệp: resultPcdurl.txt và resultErrurl.txt
Liên kết Repo GitHub của dự án: https://github.com/LiuYuancheng/Python_Web_Attestation_Tool
Cảm ơn bạn đã dành thời gian xem chi tiết bài viết, nếu bạn có bất kỳ câu hỏi và đề xuất nào hoặc tìm thấy bất kỳ lỗi chương trình nào, vui lòng nhắn tin cho tôi. Rất cảm ơn nếu bạn có thể đưa ra một số nhận xét và chia sẻ bất kỳ lời khuyên cải tiến nào để chúng tôi có thể làm cho công việc của mình tốt hơn ~

No comment for this article.