

在本节中,我们将介绍两种简单的网页内容捕获工具:网页内容下载工具和网页截图工具。开发这些工具是为了方便收集网络数据,这些数据可用于各种大数据项目。此外,我们将探讨一个用例,其中这些工具用于批量网络钓鱼网站验证。
# Author:      Yuancheng Liu
# Created:     2024/09/10
# Version:     v_0.2.1
# Copyright:   Copyright (c) 2025 Liu Yuancheng
----------------------------------------------------------------------------------------------------
Python 网页内容下载工具
程序设计目的:我们的目标是开发一个专为大数据项目量身定制的 Python 库,专门用于数据收集。该库将有助于抓取和下载与多批网页相关的所有组件,包括 .html 文件、.css 样式表、图像、XML 文件、视频、JavaScript 文件和主机 SSL 证书,基于提供的 URL 列表。
程序工作流程如下图所示:

简介
该模块提供了一个 API,用于下载网页的各种组件,包括 HTML 文件、图像、CSS 文件、XML 文件、JavaScript 文件和超链接,基于输入的 URL(必须以“http”或“https”开头)。该模块的输入和输出流程如下图所示:

该库将首先下载 Web 主 HTML 内容,然后使用 Python `beautifulsoup` 库解析 Web HTML 文件源中的所有内容,以获取链接的 HTML、图像、Java script、CSS,然后逐个下载内容并保存在相关的本地文件夹中。它将提供一个灵活的 API,允许与其他程序无缝集成。
程序用法
用户有两种执行程序的方式:单独处理 URL 或批量处理多个 URL。
使用控制台界面
要单独处理 URL,用户可以直接运行程序并按照提供的步骤操作:
python webDownload.py
使用记录文件批量处理 URL
步骤 1:准备要处理的 URL 列表,方法是将它们复制到 URL 记录文件“urllist.txt”中。
步骤 2:导航到程序文件夹并使用以下命令执行程序:`python testCase.py`
步骤 3:检查结果:
例如,如果您将 URL "https://www.carousell.sg/" 作为要检查的第一个 URL 复制到文件 "urllist.txt" 文件中,则所有 HTML 文件、图像文件和 js 文件都将位于文件夹 "`1_www.carousell.sg_files`" 下。
- 主网页将保存为:"`1_www.carousell.sg_files/1_www.carousell.sg.html`"
- 页面中使用的图像将保存在文件夹中:"`1_www.carousell.sg_files/img`"
- 通过 href 导入的 html/imge/css 将保存在文件夹中:"`1_www.carousell.sg_files/link`"
- 页面使用的 js 文件将保存在文件夹中:"`1_www.carousell.sg_files/script`"
- URL https://www.carousell.sg/ 字符串将保存在文件 1_www.carousell.sg_files/Info.txt 中。
- 主机 www.carousell 的证书将下载为文件 1_www.carousell.sg_files/cert/cert.der。
项目 GitHub Repo 链接 : https://github.com/LiuYuancheng/Py_Web_Contents_Download_Tool
----------------------------------------------------------------------------------------------------
Python 网页截图工具
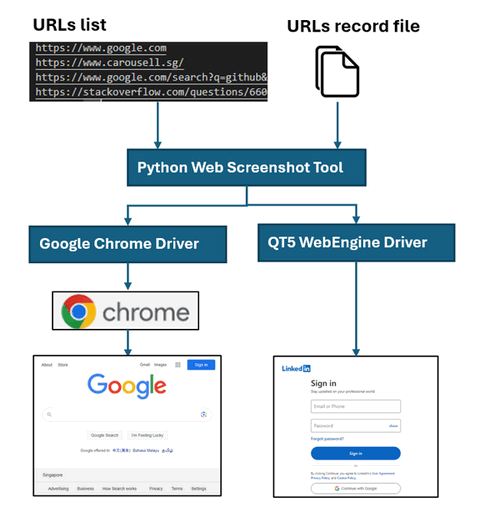
程序设计目的:我们的目标是开发一个 Python 库,用于大数据项目的数据收集,该库可以根据 URL 列表批量捕获网页屏幕截图,以支持各种编程用例。程序工作流程如下图所示:
简介
该模块使用户能够使用不同的 Web 浏览器驱动程序或 Qt5 库的 `QtWebEngineWidgets`,根据提供的 URL 捕获特定部分或整个网页的屏幕截图。用户可以通过指定“driverMode”参数来选择所需的库,以在对象初始化期间捕获网页。该模块作为单线程程序运行。模块的输入和输出流程如下所示:

该库利用两种不同的 Web 驱动程序,`Selenium Google Chrome Driver` 和 `QT5 Web Engine`,来捕获网页屏幕截图。它提供了一个灵活的 API,允许与其他程序无缝集成。
要同时处理多个 URL,用户可以将他们希望捕获的所有 URL 列在“urllist.txt”文件中,如下所示(以字符“#”开头的行将被视为注释并忽略):
# Add the URL you want to download line by line(The url must start with 'http' or 'https' ):
# example: https://www.google.com
https://www.google.com
https://www.carousell.sg/
https://www.google.com/search?q=github&sxsrf=AOaemvJh3t5_h8H85AE8Ajbb1IMnBrRISA%3A1636698503535&source=hp&ei=hwmOYY6mHdGkqtsPq8S9sAY&iflsig=ALs
之后,执行测试用例程序 `testCase.py`,捕获的屏幕截图将保存在输出文件夹 `outputFolder` 中。
程序用法
用户有两种执行程序的方式:单独处理 URL 或批量处理多个 URL。所有屏幕截图图像文件都将以 `shot_yymmdd_hhmmss.png` 格式保存在输出文件夹 `outputFolder` 下。
使用控制台界面
要单独处理 URL,用户可以直接运行程序并按照提供的步骤操作:
python webScreenShoter.py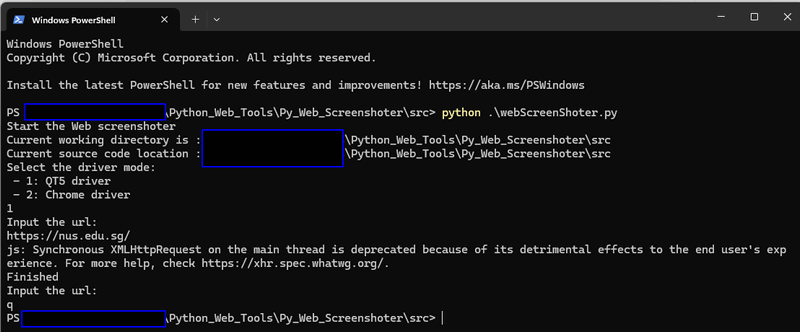
使用记录文件批量处理 URL
准备要处理的 URL 列表,方法是将它们复制到 URL 记录文件“urllist.txt”中。
导航到程序文件夹并使用以下命令执行程序:`python testCase.py`
检查结果:例如,如果“https://www.carousell.sg/”是“urllist.txt”中列出的第一个 URL,则屏幕截图文件 shot.png 将保存在文件夹“1_www.carousell.sg_files”中。
项目 GitHub Repo 链接 :
https://github.com/LiuYuancheng/Py_Web_Screenshot_Capture_Tool
----------------------------------------------------------------------------------------------------
用例:Python 网页认证工具
程序设计目的:我们想要创建一个自动化工具来检查几批 Web URL(范围从 1 到 10,000),并识别其中的网络钓鱼网站/URL。该程序将从给定的 URL 列表下载 Web 内容,然后捕获网页的屏幕截图,并将所有数据馈送到 `Phishperida` 程序中。程序工作流程如下图所示:

该项目将利用由 Yun Lin 教授和 Ruofan Liu 开发的 NUS-Phishperida 项目,用于网络钓鱼网站识别。此外,它将利用 Py_Web_Screenshot_Capture_Tool 和 Py_Web_Contents_Download_Tool 进行自动 Web 内容存档。
简介
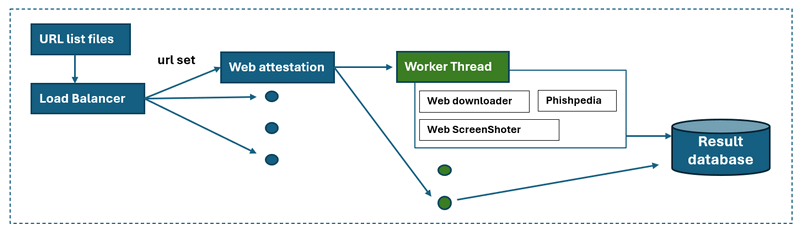
该模块是使用 `NUS-Phishperida-Project` 提供的 API 为 URL/Web 认证而设计的。它包含四个主要模块:
- DatasetLoader:负责从配置文件中批量加载 URL 数据集,并过滤已处理的 URL。
- WebDownloader:有助于抓取和下载网页组件。
- WebScreenShoter:捕获网页屏幕截图。
- PhishperidaPKG:一个包装器模块,用于调用 `Phishperida` 库并记录验证结果。
对于每个 URL,程序都会执行以下步骤:
- 利用 `WebDownloader` 模块下载所有网页组件。
- 使用 `webScreenShoter` 模块捕获网页屏幕截图。
- 将网页组件和屏幕截图传递给 `PhishperidaPKG` 进行 `siamese` 检查。
DatasetLoader 模块
- 该模块从 URL 列表加载 URL 数据,记录已处理的 URL 和错误 URL。如果程序/线程崩溃,它会在重新启动时恢复其任务,忽略已处理的 URL,并在继续处理未处理的 URL 之前删除损坏的文件。
WebDownloader 模块
- 请参阅之前的 Python 网页内容下载工具
WebScreenShoter 模块
- 请参阅之前的 Python 网页截图工具
PhishperidaPKG 模块
- 该模块用于封装 `NUS-Phishperida` 项目(非 OOP),作为一个黑盒 API 供其他项目使用。
- `NUS-Phishperida` 项目 Github Repo 链接:https://github.com/lindsey98/Phishpedia
多线程设计
使用具有后台执行控制器、多线程执行、任务平衡器的多线程:
程序用法
将要检查的 URL 复制到 URL 记录文件“urllist.txt”中
Cd 到程序文件夹并运行程序执行 cmd:
python webAttestation.py在文件 `resultPcdurl.txt` 和 `resultErrurl.txt` 中检查处理结果
项目 GitHub Repo 链接: https://github.com/LiuYuancheng/Python_Web_Attestation_Tool
感谢您花时间查看文章详细信息,如果您有任何问题和建议或发现任何程序错误,请随时给我留言。非常感谢您能提出一些意见并分享任何改进建议,以便我们能够改进我们的工作~

No comment for this article.