

在本節中,我們將介紹兩種簡單的網頁內容擷取工具:「網頁內容下載工具」和「網頁螢幕截圖工具」。開發這些工具是為了方便收集網路資料,這些資料可用於各種大數據專案。此外,我們將探討一個使用案例,其中這些工具被用於批量網路釣魚網站驗證。
# Author:      Yuancheng Liu
# Created:     2024/09/10
# Version:     v_0.2.1
# Copyright:   Copyright (c) 2025 Liu Yuancheng
----------------------------------------------------------------------------------------------------
Python 網頁內容下載工具
程式設計目的:我們的目標是開發一個專為大數據專案量身定制的 Python 函式庫,專門用於資料收集。該函式庫將有助於抓取和下載與多個批次的網頁相關的所有元件,包括 .html 檔案、.css 樣式表、圖片、XML 檔案、影片、JavaScript 檔案和主機 SSL 憑證,所有這些都基於提供的 URL 列表。
程式的工作流程如下所示:

簡介
此模組提供了一個 API,用於下載網頁的各種元件,包括 HTML 檔案、圖片、CSS 檔案、XML 檔案、JavaScript 檔案和超連結,所有這些都基於輸入的 URL(必須以 'http' 或 'https' 開頭)。該模組的輸入和輸出流程如下圖所示:

該函式庫將首先下載網頁的主要 html 內容,然後使用 python beautifulsoup lib 解析網頁 html 檔案來源中的所有內容,以取得連結的 html、圖片、java script、css,然後逐一下載這些內容並儲存在相關的本機資料夾中。它將提供一個靈活的 API,可以與其他程式無縫整合。
程式使用方式
使用者有兩個選項來執行程式:單獨處理 URL 或批量處理多個 URL。
使用主控台介面
若要單獨處理 URL,使用者可以直接執行程式並按照提供的步驟操作:
python webDownload.py
使用記錄檔批量處理 URL
步驟 1:準備要處理的 URL 列表,方法是將它們複製到 URL 記錄檔 "urllist.txt" 中。
步驟 2:導航到程式資料夾並使用以下命令執行程式:python testCase.py
步驟 3:檢查結果:
例如,如果您將 url "https://www.carousell.sg/" 作為您要檢查的第一個 url 複製到檔案 "urllist.txt" 檔案中,則所有 html 檔案、圖片檔案和 js 檔案都將位於資料夾 "`1_www.carousell.sg_files`" 下。
- 主網頁將儲存為:"`1_www.carousell.sg_files/1_www.carousell.sg.html`"
- 頁面中使用的圖片將儲存在資料夾:"`1_www.carousell.sg_files/img`"
- href 匯入的 html/imge/css 將儲存在資料夾:"`1_www.carousell.sg_files/link`"
- 頁面使用的 js 檔案將儲存在資料夾:"`1_www.carousell.sg_files/script`"
- url https://www.carousell.sg/ 字串將儲存在檔案 1_www.carousell.sg_files/Info.txt 中。
- 主機 www.carousell 的憑證將下載為檔案 1_www.carousell.sg_files/cert/cert.der。
專案 GitHub Repo 連結 : https://github.com/LiuYuancheng/Py_Web_Contents_Download_Tool
----------------------------------------------------------------------------------------------------
Python 網頁螢幕截圖工具
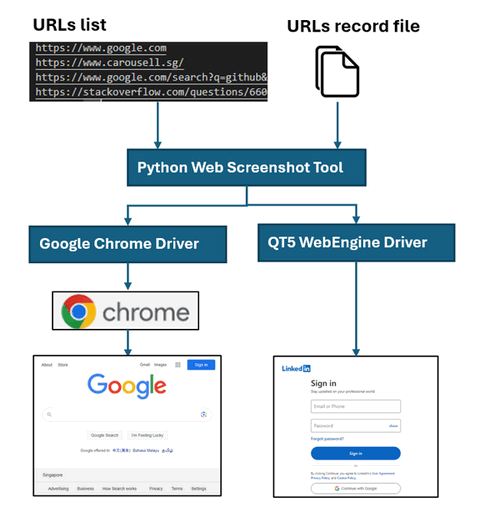
程式設計目的:我們的目標是為 bigdata 專案的資料收集目的開發一個 Python 函式庫,該函式庫可以根據 URL 列表批量擷取網頁螢幕截圖,以支援各種程式化使用案例。程式的工作流程如下所示:
簡介
此模組允許使用者使用不同的網頁瀏覽器驅動程式或 Qt5 函式庫的 QtWebEngineWidgets,根據提供的 URL 擷取特定部分或整個網頁的螢幕截圖。使用者可以在物件初始化期間透過指定 "driverMode" 參數來選擇用於擷取網頁的所需函式庫。該模組作為單執行緒程式運作。模組的輸入和輸出流程如下所示:

該函式庫利用兩種不同的網頁驅動程式,Selenium Google Chrome Driver 和 QT5 Web Engine,來擷取網頁螢幕截圖。它提供了一個靈活的 API,可以與其他程式無縫整合。
若要同時處理多個 URL,使用者可以將他們想要擷取的所有 URL 列在 "urllist.txt" 檔案中,如下所示(以字元 '#' 開頭的行將被視為註解並忽略):
# Add the URL you want to download line by line(The url must start with 'http' or 'https' ):
# example: https://www.google.com
https://www.google.com
https://www.carousell.sg/
https://www.google.com/search?q=github&sxsrf=AOaemvJh3t5_h8H85AE8Ajbb1IMnBrRISA%3A1636698503535&source=hp&ei=hwmOYY6mHdGkqtsPq8S9sAY&iflsig=ALs
之後,執行測試案例程式 testCase.py,擷取的螢幕截圖將儲存在輸出資料夾 outputFolder 中。
程式使用方式
使用者有兩個選項來執行程式:單獨處理 URL 或批量處理多個 URL。所有螢幕截圖影像檔案都將以 shot_yymmdd_hhmmss.png 格式儲存在輸出資料夾 outputFolder 下。
使用主控台介面
若要單獨處理 URL,使用者可以直接執行程式並按照提供的步驟操作:
python webScreenShoter.py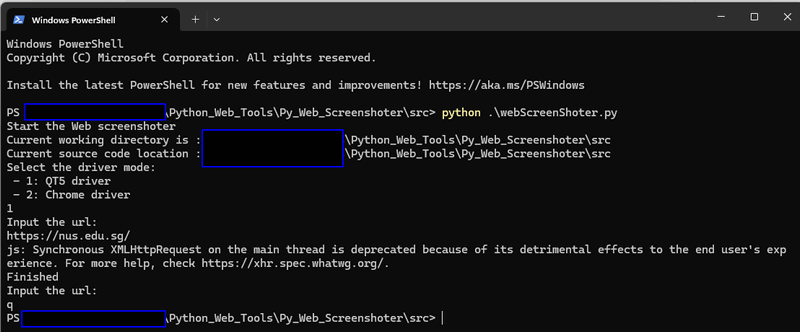
使用記錄檔批量處理 URL
準備要處理的 URL 列表,方法是將它們複製到 URL 記錄檔 "urllist.txt" 中。
導航到程式資料夾並使用以下命令執行程式:python testCase.py
檢查結果:例如,如果 "https://www.carousell.sg/" 是 "urllist.txt" 中列出的第一個 URL,則螢幕截圖檔案 shot.png 將儲存在資料夾 "1_www.carousell.sg_files" 中。
專案 GitHub Repo 連結 :
https://github.com/LiuYuancheng/Py_Web_Screenshot_Capture_Tool
----------------------------------------------------------------------------------------------------
使用案例:Python 網頁驗證工具
程式設計目的:我們想要建立一個自動化工具來檢查幾個批次的網頁 URL(範圍從 1 到 10,000),並識別其中的網路釣魚網站/URL。該程式將從給定的 URL 列表下載網頁內容,然後擷取網頁的螢幕截圖,並將所有資料饋送到 Phishperida 程式中。程式的工作流程如下所示:

該專案將利用由 Yun Lin 教授和 Ruofan Liu 開發的 NUS-Phishperida 專案,用於網路釣魚網站識別。此外,它將利用 Py_Web_Screenshot_Capture_Tool 和 Py_Web_Contents_Download_Tool 進行自動化網頁內容歸檔。
簡介
此模組專為使用 NUS-Phishperida-Project 提供的 API 進行 URL/網頁驗證而設計。它包含四個主要模組:
- DatasetLoader:負責從組態檔案中批量載入 URL 資料集,並篩選已處理的 URL。
- WebDownloader:有助於抓取和下載網頁元件。
- WebScreenShoter:擷取網頁螢幕截圖。
- PhishperidaPKG:一個封裝模組,用於調用 Phishperida 函式庫並記錄驗證結果。
對於每個 URL,程式都會執行以下步驟:
- 利用 WebDownloader 模組下載所有網頁元件。
- 使用 webScreenShoter 模組擷取網頁螢幕截圖。
- 將網頁元件和螢幕截圖傳遞給 PhishperidaPKG 進行 siamese 檢查。
DatasetLoader 模組
- 此模組從 URL 列表中載入 URL 資料,記錄已處理的 URL 和錯誤 URL。如果程式/執行緒崩潰,它會在重新啟動時恢復其任務,忽略已處理的 URL 並在繼續處理未處理的 URL 之前移除損壞的檔案。
WebDownloader 模組
- 請參閱先前的 Python 網頁內容下載工具
WebScreenShoter 模組
- 請參閱先前的 Python 網頁螢幕截圖工具
PhishperidaPKG 模組
- 此模組用於封裝 NUS-Phishperida 專案(非 OOP),作為其他專案使用的黑盒 API。
- NUS-Phishperida 專案 Github Repo 連結:https://github.com/lindsey98/Phishpedia
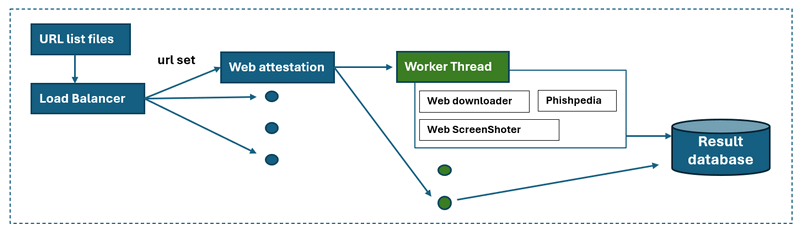
多執行緒設計
使用具有背景執行控制器、多執行緒執行、任務平衡器的多執行緒:
程式使用方式
將您要檢查的 url 複製到 url 記錄檔 "urllist.txt" 中
Cd 到程式資料夾並執行程式執行 cmd:
python webAttestation.py在檔案中檢查處理結果:resultPcdurl.txt 和 resultErrurl.txt
專案 GitHub Repo 連結: https://github.com/LiuYuancheng/Python_Web_Attestation_Tool
感謝您花時間查看文章詳細資訊,如果您有任何問題和建議或發現任何程式錯誤,請隨時給我留言。如果您能提供一些意見並分享任何改進建議,以便我們改進工作,將不勝感激〜

No comment for this article.