

ในส่วนนี้ เราจะแนะนำเครื่องมือจับภาพเนื้อหาเว็บอย่างง่ายสองอย่าง: เครื่องมือดาวน์โหลดเนื้อหาเว็บ และเครื่องมือจับภาพหน้าจอเว็บ เครื่องมือเหล่านี้ได้รับการพัฒนาขึ้นเพื่ออำนวยความสะดวกในการรวบรวมข้อมูลเว็บ ซึ่งสามารถนำไปใช้ในโครงการบิ๊กดาต้าต่างๆ ได้ นอกจากนี้ เราจะสำรวจกรณีการใช้งานที่เครื่องมือเหล่านี้ถูกนำไปใช้สำหรับการตรวจสอบเว็บไซต์ฟิชชิ่งเป็นชุด
# Author:      Yuancheng Liu
# Created:     2024/09/10
# Version:     v_0.2.1
# Copyright:   Copyright (c) 2025 Liu Yuancheng
----------------------------------------------------------------------------------------------------
เครื่องมือดาวน์โหลดเนื้อหาเว็บด้วย Python
จุดประสงค์ในการออกแบบโปรแกรม: เป้าหมายของเราคือการพัฒนาไลบรารี Python ที่ปรับให้เหมาะกับโครงการบิ๊กดาต้า โดยออกแบบมาโดยเฉพาะเพื่อวัตถุประสงค์ในการรวบรวมข้อมูล ไลบรารีนี้จะอำนวยความสะดวกในการขูดและดาวน์โหลดส่วนประกอบทั้งหมดที่เกี่ยวข้องกับเว็บเพจหลายชุด รวมถึงไฟล์ .html, สไตล์ชีต .css, รูปภาพ, ไฟล์ XML, วิดีโอ, ไฟล์ JavaScript และใบรับรอง SSL ของโฮสต์ โดยอิงตามรายการ URL ที่ให้มา
ขั้นตอนการทำงานของโปรแกรมแสดงดังรูปด้านล่าง:

บทนำ
โมดูลนี้มี API สำหรับดาวน์โหลดส่วนประกอบต่างๆ ของเว็บเพจ รวมถึงไฟล์ HTML, รูปภาพ, ไฟล์ CSS, ไฟล์ XML, ไฟล์ JavaScript และลิงก์ไฮเปอร์ลิงก์ โดยอิงตาม URL อินพุต (ซึ่งต้องขึ้นต้นด้วย 'http' หรือ 'https') โฟลว์อินพุตและเอาต์พุตของโมดูลแสดงอยู่ในไดอะแกรมด้านล่าง:

ไลบรารีจะดาวน์โหลดเนื้อหา html หลักของเว็บก่อน จากนั้นใช้ lib beautifulsoup ของ python เพื่อแยกวิเคราะห์เนื้อหาทั้งหมดจากซอร์สไฟล์ html ของเว็บ เพื่อรับ html, รูปภาพ, java script, css ที่เชื่อมโยง จากนั้นดาวน์โหลดเนื้อหาทีละรายการและบันทึกในโฟลเดอร์โลคัลที่เกี่ยวข้อง โดยจะมี API ที่ยืดหยุ่นซึ่งช่วยให้สามารถรวมเข้ากับโปรแกรมอื่นได้อย่างราบรื่น
การใช้งานโปรแกรม
ผู้ใช้มีสองตัวเลือกสำหรับการเรียกใช้โปรแกรม: ประมวลผล URL ทีละรายการ หรือประมวลผล URL หลายรายการเป็นชุด
ใช้ส่วนต่อประสานคอนโซล
ในการประมวลผล URL ทีละรายการ ผู้ใช้สามารถเรียกใช้โปรแกรมได้โดยตรงและทำตามขั้นตอนที่ให้ไว้:
python webDownload.py
ประมวลผล URL เป็นชุดด้วยไฟล์บันทึก
ขั้นตอนที่ 1: เตรียมรายการ URL ที่จะประมวลผลโดยคัดลอกลงในไฟล์บันทึก URL "urllist.txt"
ขั้นตอนที่ 2: นำทางไปยังโฟลเดอร์โปรแกรมและเรียกใช้โปรแกรมโดยใช้คำสั่งต่อไปนี้: python testCase.py
ขั้นตอนที่ 3 ตรวจสอบผลลัพธ์:
ตัวอย่างเช่น หากคุณคัดลอก url "https://www.carousell.sg/" เป็น url แรกที่คุณต้องการตรวจสอบลงในไฟล์ "urllist.txt" ไฟล์ html, ไฟล์รูปภาพ และไฟล์ js ทั้งหมดจะอยู่ภายใต้โฟลเดอร์ "`1_www.carousell.sg_files`"
- หน้าเว็บหลักจะถูกบันทึกเป็น: "`1_www.carousell.sg_files/1_www.carousell.sg.html`"
- รูปภาพที่ใช้ในหน้าจะถูกบันทึกในโฟลเดอร์: "`1_www.carousell.sg_files/img`"
- html/imge/css ที่นำเข้าโดย href จะถูกบันทึกในโฟลเดอร์: "`1_www.carousell.sg_files/link`"
- ไฟล์ js ที่ใช้โดยหน้าจะถูกบันทึกในโฟลเดอร์: "`1_www.carousell.sg_files/script`"
- สตริง url https://www.carousell.sg/ จะถูกบันทึกในไฟล์ 1_www.carousell.sg_files/Info.txt
- ใบรับรองของโฮสต์ www.carousell จะถูกดาวน์โหลดเป็นไฟล์ 1_www.carousell.sg_files/cert/cert.der
ลิงก์ไปยัง Repo GitHub ของโปรเจ็กต์ : https://github.com/LiuYuancheng/Py_Web_Contents_Download_Tool
----------------------------------------------------------------------------------------------------
เครื่องมือจับภาพหน้าจอเว็บด้วย Python
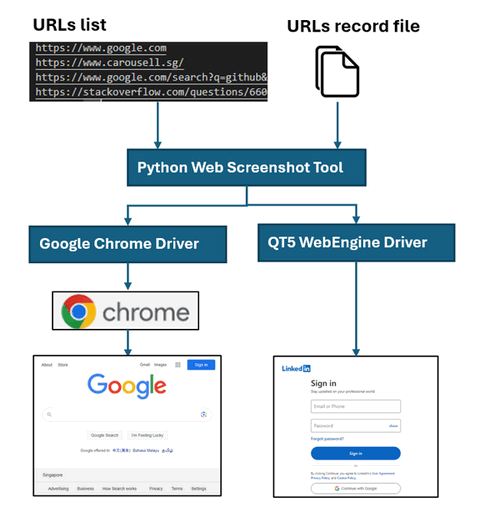
จุดประสงค์ในการออกแบบโปรแกรม: วัตถุประสงค์ของเราคือการพัฒนาไลบรารี Python สำหรับวัตถุประสงค์ในการรวบรวมข้อมูลของโปรเจ็กต์บิ๊กดาต้า ซึ่งสามารถจับภาพหน้าจอเว็บเป็นชุด โดยอิงตามรายการ URL เพื่อรองรับกรณีการใช้งานเชิงโปรแกรมต่างๆ ขั้นตอนการทำงานของโปรแกรมแสดงดังรูปด้านล่าง:
บทนำ
โมดูลนี้ช่วยให้ผู้ใช้สามารถจับภาพหน้าจอของส่วนที่เฉพาะเจาะจงหรือทั้งหน้าเว็บโดยใช้ไดรเวอร์เว็บเบราว์เซอร์ต่างๆ หรือ QtWebEngineWidgets ของไลบรารี Qt5 โดยอิงตาม URL ที่ให้มา ผู้ใช้สามารถเลือกไลบรารีที่ต้องการสำหรับการจับภาพหน้าเว็บระหว่างการเริ่มต้นอ็อบเจ็กต์โดยการระบุพารามิเตอร์ "driverMode" โมดูลนี้ทำงานเป็นโปรแกรม Single-Threaded โฟลว์อินพุตและเอาต์พุตของโมดูลแสดงอยู่ด้านล่าง:

ไลบรารีใช้เว็บไดรเวอร์สองตัวที่แตกต่างกัน, Selenium Google Chrome Driver และ QT5 Web Engine, เพื่อจับภาพหน้าจอเว็บ โดยจะมี API ที่ยืดหยุ่นซึ่งช่วยให้สามารถรวมเข้ากับโปรแกรมอื่นได้อย่างราบรื่น
ในการประมวลผล URL หลายรายการพร้อมกัน ผู้ใช้สามารถแสดงรายการ URL ทั้งหมดที่ต้องการจับภาพในไฟล์ "urllist.txt" ดังที่แสดงด้านล่าง (บรรทัดที่ขึ้นต้นด้วยอักขระ '#' จะถือเป็นความคิดเห็นและถูกละเว้น):
# Add the URL you want to download line by line(The url must start with 'http' or 'https' ):
# example: https://www.google.com
https://www.google.com
https://www.carousell.sg/
https://www.google.com/search?q=github&sxsrf=AOaemvJh3t5_h8H85AE8Ajbb1IMnBrRISA%3A1636698503535&source=hp&ei=hwmOYY6mHdGkqtsPq8S9sAY&iflsig=ALs
หลังจากนั้น ให้เรียกใช้โปรแกรม test case testCase.py และภาพหน้าจอที่จับภาพจะถูกบันทึกในโฟลเดอร์เอาต์พุต outputFolder
การใช้งานโปรแกรม
ผู้ใช้มีสองตัวเลือกสำหรับการเรียกใช้โปรแกรม: ประมวลผล URL ทีละรายการ หรือประมวลผล URL หลายรายการเป็นชุด ไฟล์ภาพหน้าจอทั้งหมดจะถูกบันทึกในโฟลเดอร์เอาต์พุต outputFolder ภายใต้รูปแบบ shot_yymmdd_hhmmss.png
ใช้ส่วนต่อประสานคอนโซล
ในการประมวลผล URL ทีละรายการ ผู้ใช้สามารถเรียกใช้โปรแกรมได้โดยตรงและทำตามขั้นตอนที่ให้ไว้:
python webScreenShoter.py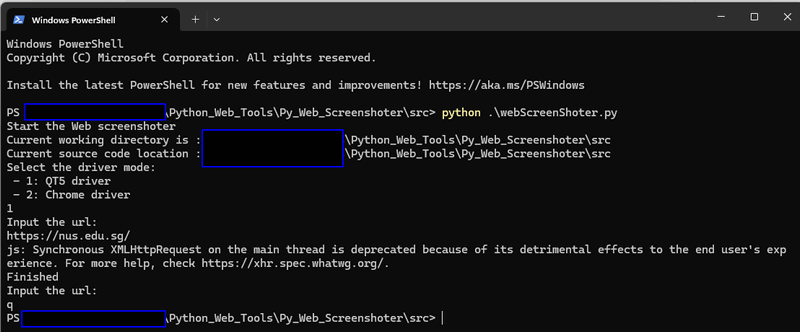
ประมวลผล URL เป็นชุดด้วยไฟล์บันทึก
เตรียมรายการ URL ที่จะประมวลผลโดยคัดลอกลงในไฟล์บันทึก URL "urllist.txt"
นำทางไปยังโฟลเดอร์โปรแกรมและเรียกใช้โปรแกรมโดยใช้คำสั่งต่อไปนี้: python testCase.py
ตรวจสอบผลลัพธ์: ตัวอย่างเช่น หาก "https://www.carousell.sg/" เป็น URL แรกที่แสดงรายการใน "urllist.txt" ไฟล์ภาพหน้าจอ shot.png จะถูกบันทึกในโฟลเดอร์ "1_www.carousell.sg_files"
ลิงก์ไปยัง Repo GitHub ของโปรเจ็กต์ :
https://github.com/LiuYuancheng/Py_Web_Screenshot_Capture_Tool
----------------------------------------------------------------------------------------------------
กรณีการใช้งาน: เครื่องมือรับรองความถูกต้องเว็บด้วย Python
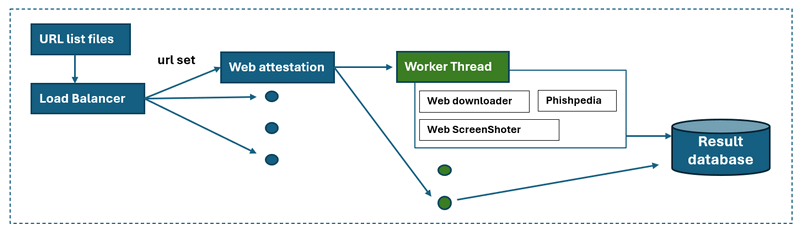
จุดประสงค์ในการออกแบบโปรแกรม: เราต้องการสร้างเครื่องมืออัตโนมัติเพื่อตรวจสอบ URL เว็บหลายชุด (ตั้งแต่ 1 ถึง 10,000) และระบุเว็บไซต์/URL ฟิชชิ่งในหมู่พวกเขา โปรแกรมจะดาวน์โหลดเนื้อหาเว็บจากรายการ URL ที่กำหนด จากนั้นจับภาพหน้าจอของหน้าเว็บ และป้อนข้อมูลทั้งหมดลงในโปรแกรม Phishperida ขั้นตอนการทำงานของโปรแกรมแสดงดังรูปด้านล่าง:

โปรเจ็กต์จะใช้ประโยชน์จาก โปรเจ็กต์ NUS-Phishperida ซึ่งพัฒนาโดย Prof. Yun Lin และ Ruofan Liu สำหรับการระบุเว็บไซต์ฟิชชิ่ง นอกจากนี้ จะใช้ Py_Web_Screenshot_Capture_Tool และ Py_Web_Contents_Download_Tool สำหรับการเก็บถาวรเนื้อหาเว็บอัตโนมัติ
บทนำ
โมดูลนี้สร้างขึ้นสำหรับการรับรองความถูกต้องของ URL/เว็บ โดยใช้ API ที่จัดทำโดย NUS-Phishperida-Project ประกอบด้วยสี่โมดูลหลัก:
- DatasetLoader: รับผิดชอบในการโหลดชุดข้อมูล URL จากไฟล์กำหนดค่าเป็นชุด และกรอง URL ที่ประมวลผลแล้ว
- WebDownloader: อำนวยความสะดวกในการขูดและดาวน์โหลดส่วนประกอบของหน้าเว็บ
- WebScreenShoter: จับภาพหน้าจอเว็บ
- PhishperidaPKG: โมดูล Wrapper เพื่อเรียกใช้ไลบรารี Phishperida และบันทึกผลการตรวจสอบ
สำหรับแต่ละ URL โปรแกรมจะดำเนินการตามขั้นตอนต่อไปนี้:
- ใช้โมดูล WebDownloader เพื่อดาวน์โหลดส่วนประกอบหน้าเว็บทั้งหมด
- ใช้โมดูล webScreenShoter เพื่อจับภาพหน้าจอเว็บ
- ส่งส่วนประกอบหน้าเว็บและภาพหน้าจอไปยัง PhishperidaPKG สำหรับการตรวจสอบแบบ Siamese
โมดูล DatasetLoader
- โมดูลนี้โหลดข้อมูล URL จากรายการ URL บันทึก URL ที่ประมวลผลแล้วและ URL ที่มีข้อผิดพลาด ในกรณีที่โปรแกรม/เธรดขัดข้อง จะดำเนินการต่อเมื่อเริ่มต้นใหม่ โดยละเว้น URL ที่ประมวลผลแล้วและลบไฟล์ที่เสียหายก่อนที่จะดำเนินการต่อด้วย URL ที่ยังไม่ได้ประมวลผล
โมดูล WebDownloader
- อ้างอิงถึงเครื่องมือดาวน์โหลดเนื้อหาเว็บด้วย Python ก่อนหน้า
โมดูล WebScreenShoter
- อ้างอิงถึงเครื่องมือจับภาพหน้าจอเว็บด้วย Python ก่อนหน้า
โมดูล PhishperidaPKG
- โมดูลนี้ใช้เพื่อห่อหุ้มโปรเจ็กต์ NUS-Phishperida (ไม่ใช่ OOP) เป็น API กล่องดำเพื่อให้โปรเจ็กต์อื่นใช้งาน
- ลิงก์ไปยัง Repo Github ของโปรเจ็กต์ NUS-Phishperida : https://github.com/lindsey98/Phishpedia
การออกแบบ Multi-Threading
ใช้ Multi-Thread พร้อมตัวควบคุมการดำเนินการเบื้องหลัง, การดำเนินการ Multithread, ตัวปรับสมดุลงาน:
การใช้งานโปรแกรม
คัดลอก url ที่คุณต้องการตรวจสอบในไฟล์บันทึก url "urllist.txt"
Cd ไปยังโฟลเดอร์โปรแกรมและเรียกใช้ cmd การดำเนินการโปรแกรม:
python webAttestation.pyตรวจสอบผลลัพธ์ของกระบวนการในไฟล์: resultPcdurl.txt และ resultErrurl.txt
ลิงก์ไปยัง Repo GitHub ของโปรเจ็กต์: https://github.com/LiuYuancheng/Python_Web_Attestation_Tool
ขอบคุณที่สละเวลาตรวจสอบรายละเอียดบทความ หากคุณมีคำถามและข้อเสนอแนะ หรือพบข้อผิดพลาดของโปรแกรม โปรดส่งข้อความถึงฉันได้เลย ขอบคุณมากหากคุณสามารถให้ความคิดเห็นและแบ่งปันคำแนะนำในการปรับปรุงใดๆ เพื่อให้เราสามารถปรับปรุงงานของเราให้ดีขึ้นได้ ~

No comment for this article.