Deploying DeepSeek-R1 Locally with a Custom RAG Knowledge Data Base

English 简体中文 繁体中文 ภาษาไทย Tiếng Việt
Summary

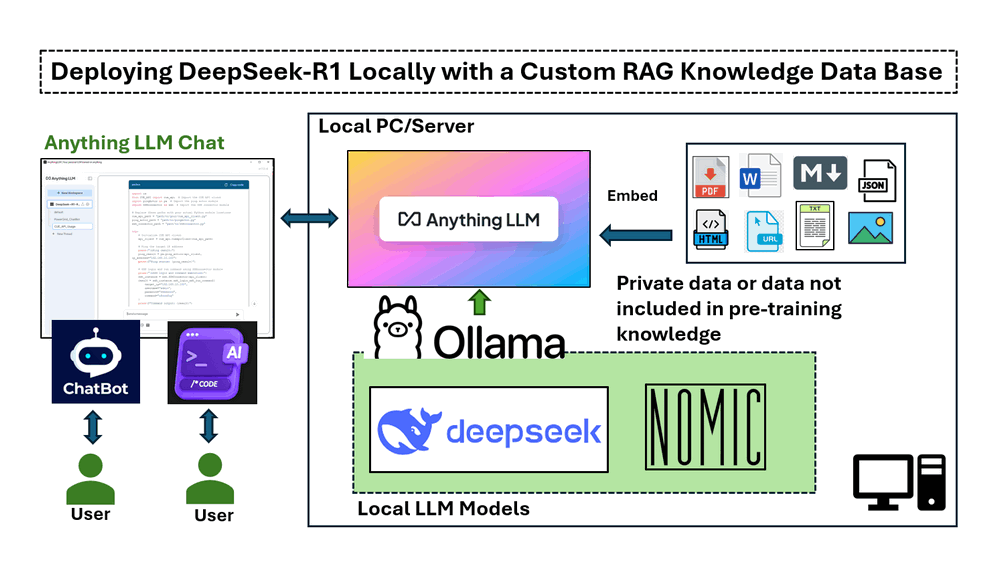
Deploying DeepSeek-R1 locally with a custom Retrieval-Augmented Generation (RAG) knowledge base enables powerful, domain-specific AI applications while ensuring data privacy. This setup involves using Ollama to run DeepSeek-R1, nomic-embed-text for vector embeddings, and AnythingLLM to integrate documents and manage the RAG pipeline. The process demonstrates how to load proprietary data, transforming the LLM into an expert system for tasks like AI chatbots or code generation. Testing revealed significant improvements in response accuracy and relevance when RAG was enabled, though human oversight remains crucial for generated code. This approach offers a robust solution for localized, intelligent insights grounded in specific knowledge.

專案設計目的:本文的主要目標是探討如何部署 DeepSeek-R1 這個開源大型語言模型 (LLM),並將其與本地機器 (PC/伺服器) 上的客製化 Retrieval-Augmented Generation (RAG) 知識庫整合。此設定使模型能夠利用特定領域的知識來提供專家級的回應,同時保持資料隱私和客製化彈性。 透過這樣做,使用者可以增強模型在特定技術領域的專業知識,從而實現諸如 AI 驅動的支援聊天機器人、私有程式碼生成和特定行業助理等應用。 最重要的是,此設定允許使用者保護專有資料的隱私,確保敏感文件、授權軟體或非公開資訊保持安全,同時仍然可以從 AI 驅動的洞察中受益。

本文中的實作涵蓋四個主要部分:

  • 在本地安裝和執行 DeepSeek-R1 在具有 NVIDIA RTX 3060 GPU 的 Windows 機器上。

  • 設定 RAG 管道 使用 nomic-embed-text 進行基於向量的文字檢索。

  • 部署 AnythingLLM 以整合基於文件的 AI 回應。

  • 測試 DeepSeek-R1 在有和沒有 RAG 的情況下,展示其在回應特定領域查詢方面的準確性。

# Version:     v_0.0.1
# Created:     2025/02/06
# License:     MIT License

簡介

DeepSeek 是一家中國 AI 公司,正以其低成本、開源的大型語言模型顛覆該行業,挑戰美國科技巨頭。 它在數學、編碼、英語和中文對話方面表現出高性能。 DeepSeek-R1 模型是開源的(MIT License)。 本文將探討在具有 NVIDIA RTX 3060 (12GB GPU) 的 Windows 筆記型電腦上部署 DeepSeek-R1:7B LLM 模型的詳細步驟,以使用知識庫 Retrieval-Augmented Generation (RAG) 建立客製化的 AI 驅動聊天機器人或程式碼產生器,並在正常的 LLM 答案和 RAG 答案之間進行簡單的比較。

  • 對於AI 客戶服務聊天機器人,我們希望它根據公司產品文件提供資訊,使其成為內部知識管理和客戶支援的強大工具。

  • 對於AI 程式碼產生器,我們希望它透過根據現有程式 API 產生程式碼片段或從客製化程式庫匯入函數來協助軟體開發。

為了實作這個專案,我們將使用四個關鍵工具:

  • Ollama:一個輕量級、可擴展的框架,用於在本地機器上構建和執行語言模型。> 連結

  • DeepSeek-R1:一種透過大規模強化學習 (RL) 訓練的模型,沒有監督微調 (SFT) 作為初步步驟,在推理方面表現出卓越的性能。> 連結

  • nomic-embed-text:一種開源文字嵌入模型,可將文字轉換為數值向量,使電腦能夠透過比較其表示形式與其他表示形式來理解文字的語義。> 連結

  • AnythingLLM:一個開源 AI 聊天機器人,允許使用者與文件聊天。 它旨在幫助企業和組織使其書面文件更易於存取。> 連結

這種方法顯著提高了AI 輔助的決策、技術支援和軟體開發,確保回應基於可靠的、特定領域的資訊。


背景知識

DeepSeek-R1:高效能的開源 LLM

DeepSeek AI 正在透過其 DeepSeek-R1 系列引領基於推理的大型語言模型 (LLM) 的新時代,旨在突破數學、編碼和邏輯推理能力的界限。 與傳統的 LLM 嚴重依賴監督微調 (SFT) 不同,DeepSeek AI 採用強化學習 (RL) 優先的方法,使模型能夠自然地發展複雜的推理行為。

DeepSeek-R1 模型的演進

  • DeepSeek-R1-Zero 是第一個完全透過大規模強化學習 (RL) 訓練的世代模型,使其能夠自我驗證、反思和生成長鏈思維 (CoT),而無需 SFT。 然而,它面臨諸如語言混合、可讀性問題和重複輸出等挑戰。

  • DeepSeek-R1 透過在 RL 訓練之前加入冷啟動資料來改進這一點,從而產生更精細和更符合人類的模型,其性能與 OpenAI-o1 在各種推理基準測試中相當。

參考連結:https://api-docs.deepseek.com/

了解 Retrieval-Augmented Generation (RAG)

Retrieval-augmented generation 是一種透過來自特定和相關資料來源的資訊來提高生成式 AI 模型準確性和可靠性的技術。 RAG 透過在生成回應之前檢索外部資料來增強生成式 AI 模型,從而產生更準確、最新和具有上下文意識的答案。

RAS 的工作流程如下所示:
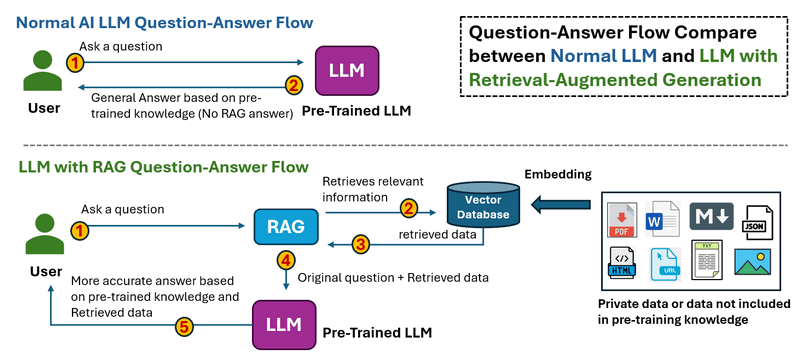
  • 在正常的 LLM 問答流程中,當使用者提出問題時。 Thee LLM 處理輸入並產生答案僅基於其預先訓練的知識。 沒有外部資料檢索,這意味著無法更正過時或遺失的資訊。

  • 在具有 RAG 的 LLM 問答流程中,當使用者提出問題時。 系統首先從外部來源(資料庫、文件、API 或網路)檢索相關資訊。 檢索到的資料與原始問題一起饋送到 LLM 中,然後 LLM 根據預先訓練的知識和檢索到的資料產生答案,從而產生更準確和最新的回應。

參考連結:https://blogs.nvidia.com/blog/what-is-retrieval-augmented-generation/


步驟 1:在您的本機電腦上部署 DeepSeek-R1 模型

若要在本機設定 DeepSeek-R1 模型,您首先需要安裝 Ollama,這是一個輕量級、可擴展的框架,用於在您的電腦上執行大型語言模型。然後,您將根據您的硬體規格下載適當的 DeepSeek-R1 模型。

1.1 安裝 Ollama

從官方網站下載 Ollama:https://ollama.com/download,然後選擇適用於您作業系統的安裝套件:
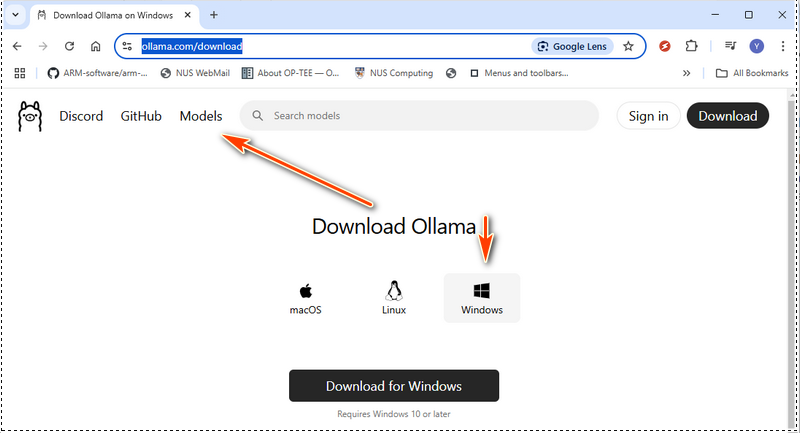
安裝完成後,請在終端機中執行以下命令,以驗證 Ollama 是否已正確安裝:

ollama --version

如果顯示版本號碼,則表示 Ollama 已準備好使用:
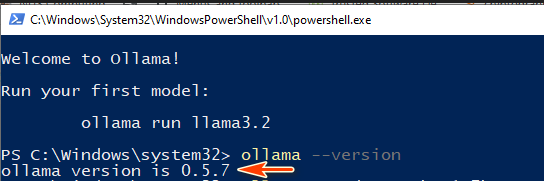
接下來,執行以下命令以啟動 Ollama 服務:

ollama serve

1.2 選擇正確的 DeepSeek-R1 模型

DeepSeek-R1 提供的模型範圍從精巧的 15 億參數版本到龐大的 6710 億參數模型。您選擇的模型大小應與您的 GPU 記憶體 (VRAM) 和系統資源相符。在 Ollama 網頁中,選擇模型,然後搜尋 deepseek,如下所示:
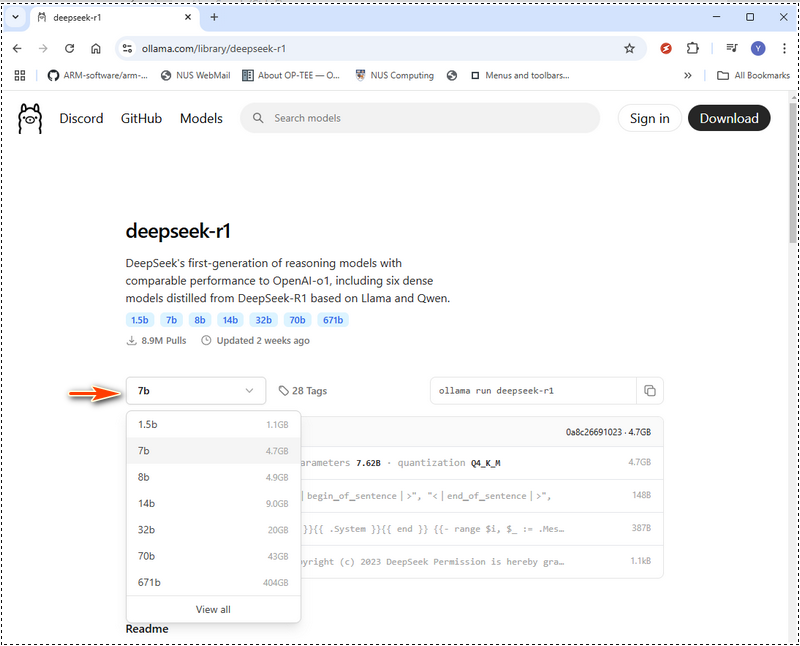
以下是一個硬體需求表,可協助您決定要部署哪個模型。如果您的硬體低於建議規格,您仍然可以使用硬體最佳化工具(如 LMStudio (https://lmstudio.ai/))執行更大的模型,但這會增加處理時間。DeepSeek-R1 硬體需求:

對於 671b 模型,大約需要 480 GB 的 VRAM。必須使用多 GPU 設定,例如:

  • 20 個 Nvidia RTX 3090 GPU(每個 24 GB)

  • 10 個 Nvidia RTX A6000 GPU(每個 48 GB)

參考:

1.3 下載並執行 DeepSeek-R1

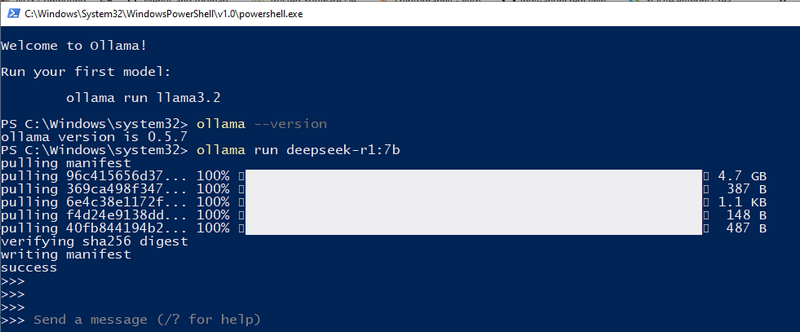
由於我的本機設定使用 3060GPU(12GB),所以我可以嘗試 7b。我們可以使用 ollama pull to down load the model 或直接使用 run 命令,如果尚未下載模組,Ollama 會自動下載:

ollama run deepseek-r1:7b

現在,DeepSeek-R1 已成功部署在您的本機電腦上,您可以開始直接從終端機提出 AI 問題。


步驟 2:安裝 nomic-embed-text

為了建立 RAG(檢索增強生成)知識庫,我們需要 nomic-embed-text,它可以將資料(例如 PDF 檔案或文字字串)轉換為向量表示。這些向量嵌入讓 AI 模型能夠理解不同文字片段之間的語義關係,從而提高搜尋和檢索的準確性。

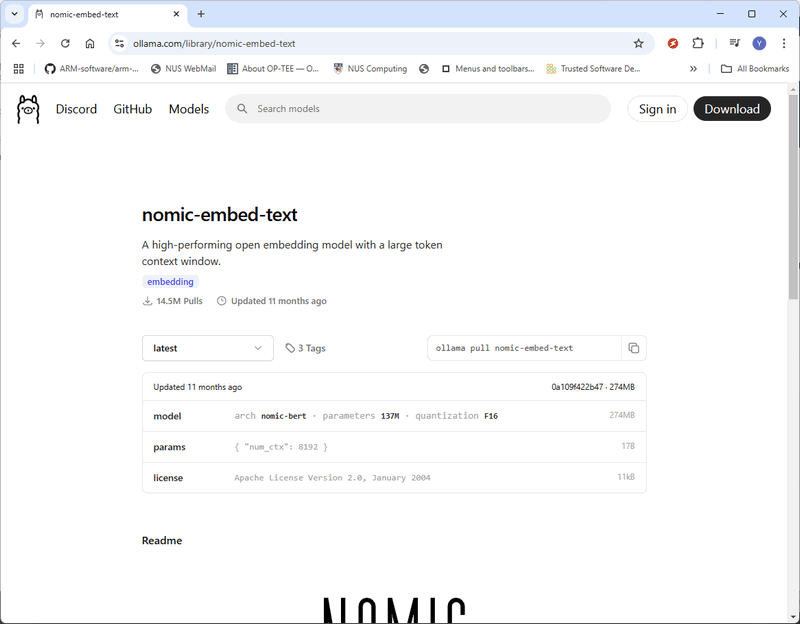
2.1 下載 nomic-embed-text

請造訪官方頁面:https://ollama.com/library/nomic-embed-text 並下載最新版本,如下所示:

2.2 透過 Ollama 安裝

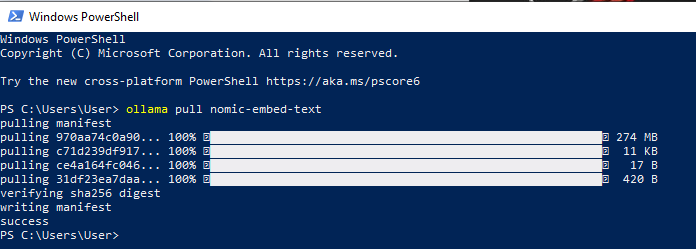
您也可以使用 Ollama pull 命令直接安裝 nomic-embed-text:

ollama pull nomic-embed-text

下載完成後,nomic-embed-text 即可整合到您的 RAG 管道中。


步驟 3:安裝 AnythingLLM 並部署 RAG

為了設定 RAG(檢索增強生成)系統,我們將使用 AnythingLLM,這是一個開放原始碼的 AI 聊天機器人,可讓您與文件進行無縫互動。

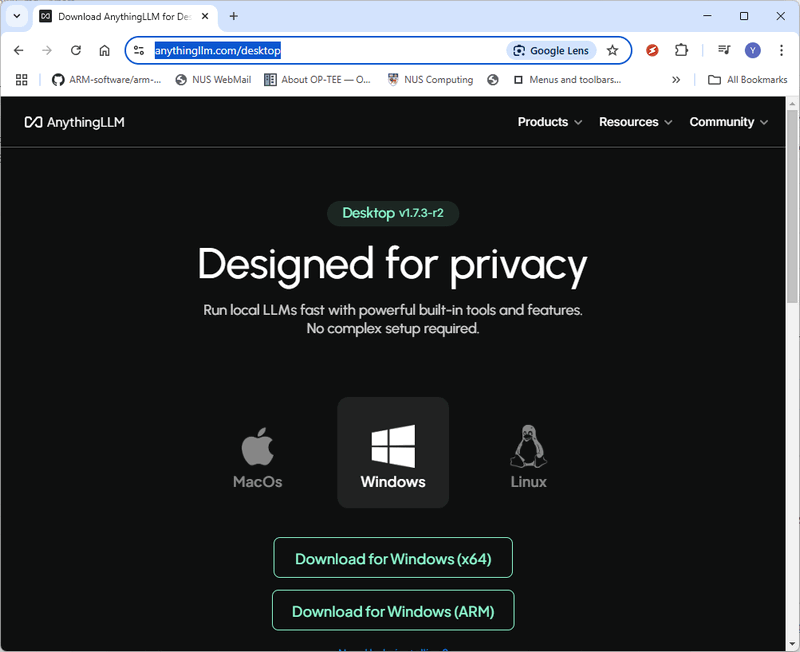
3.1 下載並安裝 AnythingLLM

請造訪官方 AnythingLLM 下載頁面:https://anythingllm.com/desktop 並下載適用於您作業系統的安裝程式。

3.2 建立工作區

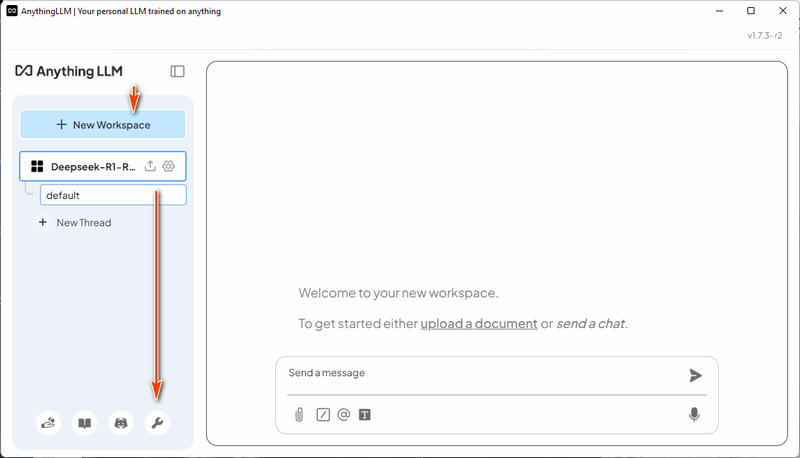
安裝並執行 AnythingLLM 之後,建立一個名為 「DeepSeek-R1-RAG」 的新工作區。然後,按一下工作區的 「開啟設定」 圖示,如下所示:

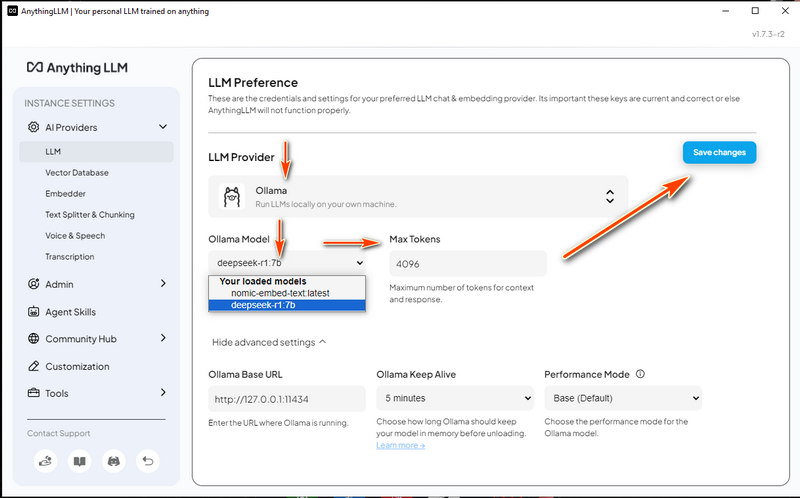
3.3 設定 LLM 設定

  • 在 LLM 提供者 區段中,選取 Ollama。

  • 選擇 DeepSeek-R1 作為 Ollama 模型。

  • 將 Max Tokens 設定為 4096(如果需要更廣泛的分析或摘要,您可以增加此值)。

  • 按一下 儲存變更 以套用設定。

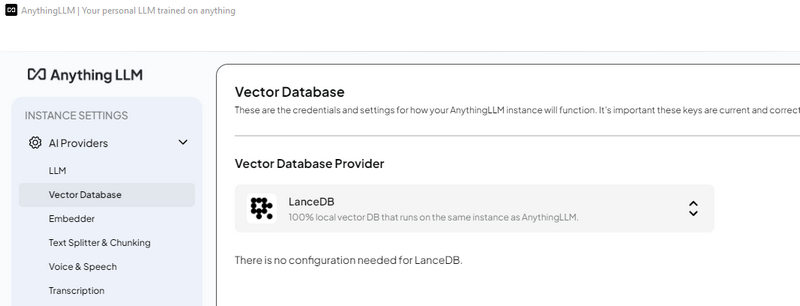
3.4 配置向量資料庫

  • 導覽至Vector Database設定。

  • 選擇LanceDB,這是一個完全本地端的向量資料庫,可將所有內容保留在您的本機電腦上,以確保資料隱私。

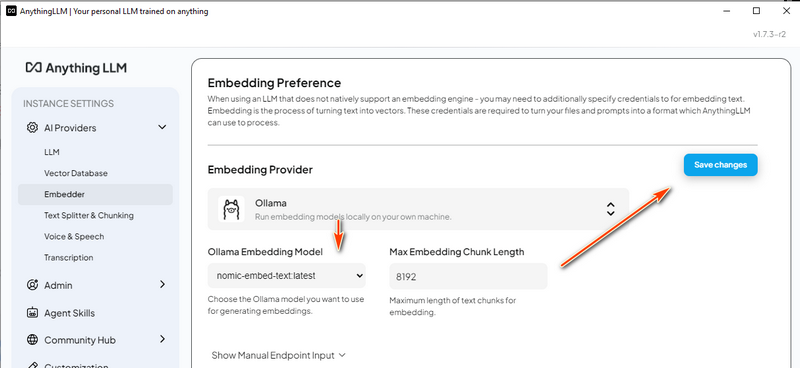
3.5 配置嵌入模型

  • 在Embedder Tag中,選擇nomic-embed-text在Ollama Embedding Model區段下。

  • 儲存變更以完成設定。


步驟 4:載入 RAG 資料並開始測試

現在我們已經完成設定,我們可以將文件載入到 RAG 系統中,並測試 DeepSeek-R1 聊天機器人。

4.1 準備知識庫

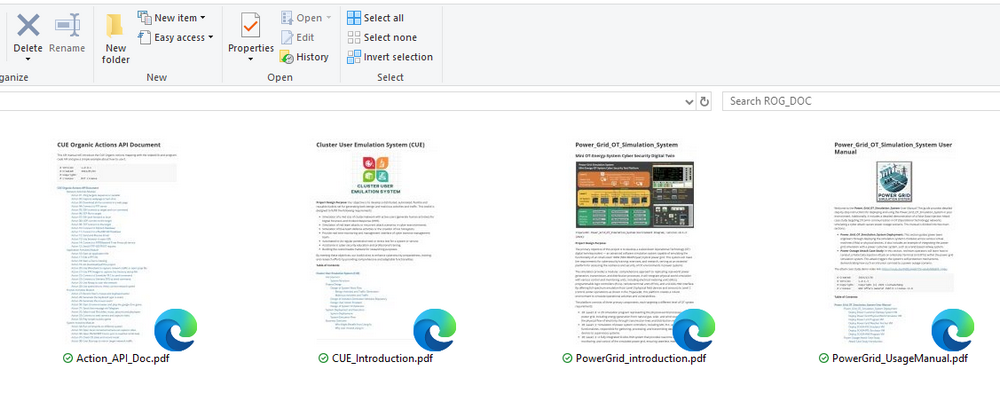
我們將使用四個PDF 文件來建立 AI 的知識庫:

電力網格模擬系統文件

  • PowerGrid_introduction.pdf – Power_Grid_OT_Simulation_System 簡介,包括系統概述、結構和子系統設計。

  • PowerGrid_UsageManual.pdf – 涵蓋系統配置、設定和使用的使用者手冊。

叢集使用者動作模擬 (CUE) 系統文件

  • CUE_Introduction.pdf – 叢集使用者模擬 (CUE) 系統的概述,涵蓋系統結構、配置和使用。

  • Action_API_Doc.pdf – Python API 文件,其中包含可用函數、參數和使用範例的詳細資訊。

4.2 載入電力網格系統資料

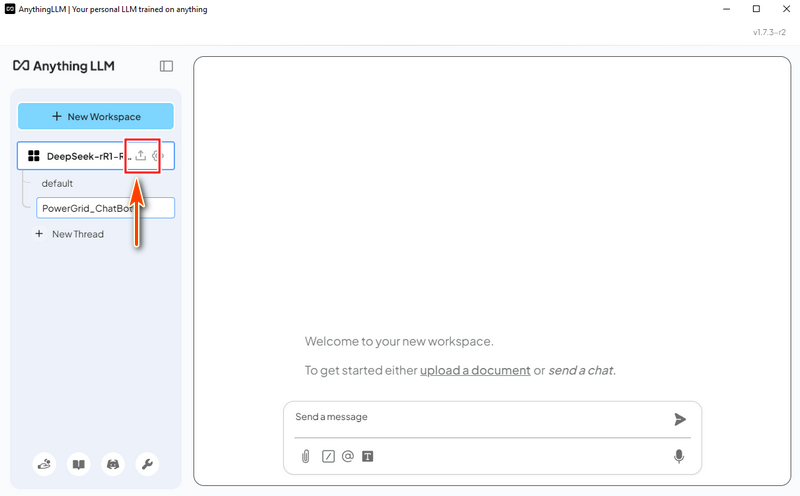
在 AnythingLLM 中,建立一個「Power Grid Chat Bot」執行緒,然後按一下上傳圖示:

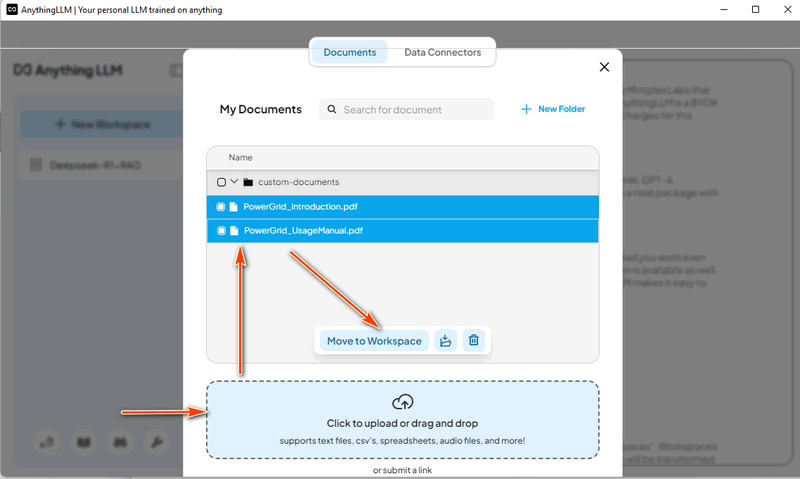
上傳 2 個 PDF 檔案PowerGrid_introduction.pdf和PowerGrid_UsageManual.pdf,然後選取這兩個檔案並按一下「移至工作區」:

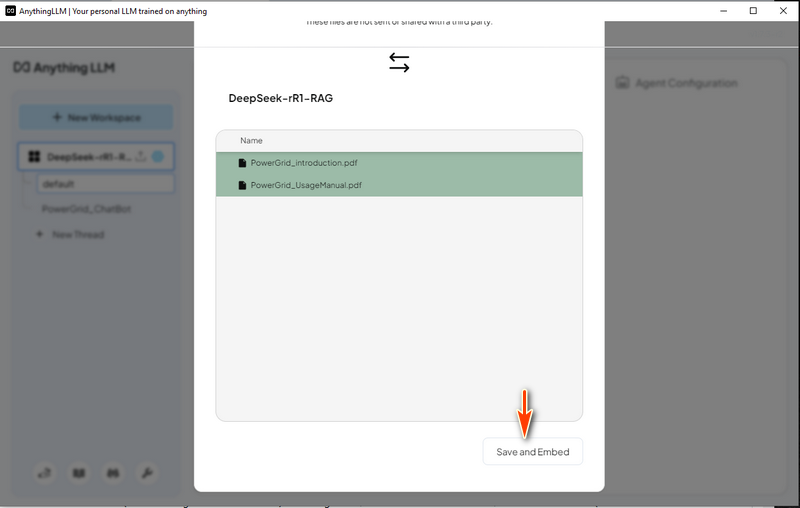
然後選取「儲存並嵌入」,如下所示,在進度完成後,具有 RAG 的 LLM 即可使用。

4.3 使用電力網格資料 RAG 測試 DeepSeek-R1 ChatBot

現在我們可以嘗試向 DeepSeek-R1 提出一個與電力網格模擬系統相關的問題,並比較有 RAG 和沒有 RAG 的答案之間的結果。

問題:

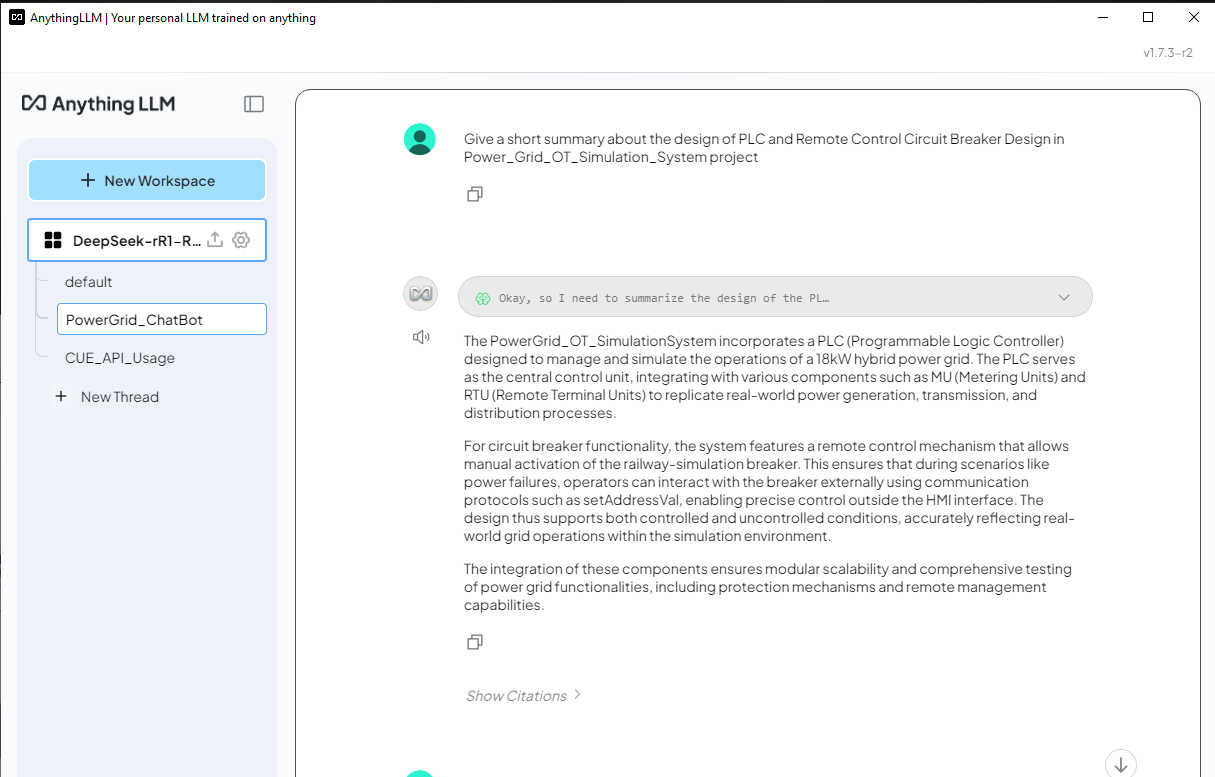
簡要概述 Power_Grid_OT_Simulation_System 專案中 PLC 和遠端控制斷路器設計的設計。

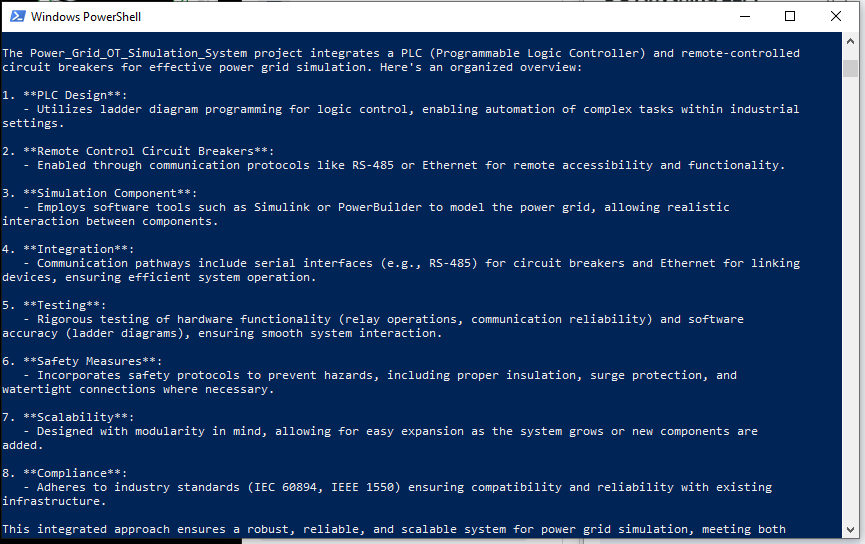
DeepSeek-R1(沒有 RAG)答案 - 對於沒有 RAG 的 DeepSeek-R1,它列出了一個非常籠統的答案,如下所示,並且回應與 Power_Grid_OT_Simulation_System 專案沒有關係:

DeepSeek-R1(已啟用 RAG) - AI 根據上傳的文件提供準確的回應,涵蓋 HMI 斷路器控制和系統詳細資訊:

4.4 載入 Cluster User Action Emulator Project Data

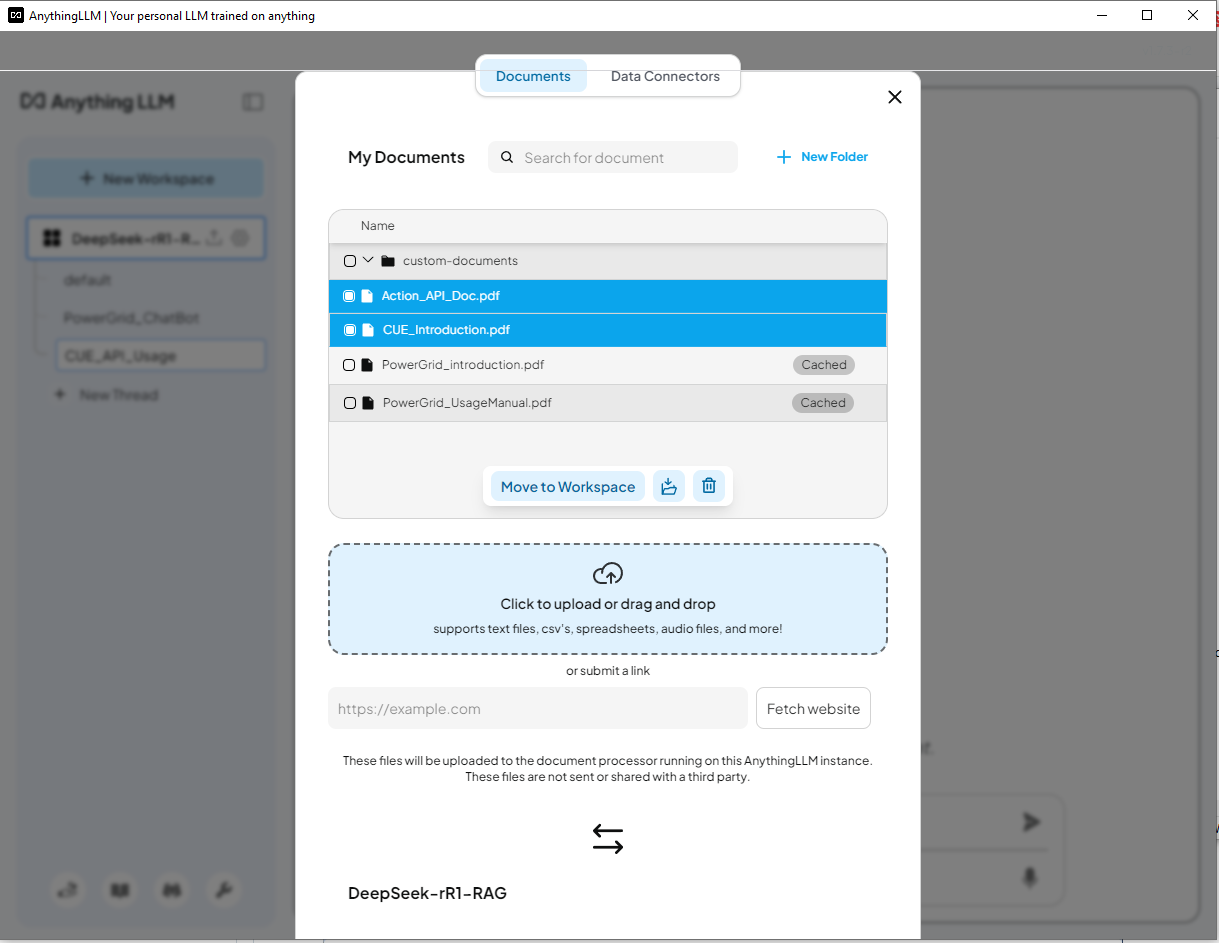
這次我們移除 power grid doc 並載入 Cluster User Action Emulator Project 的介紹文件 CUE_Introduction.pdf 以及 python code API 文件 Action_API_Doc.pdf,如下所示:

4.5 使用 CUE 資料測試 DeepSeek-R1 ChatBot

現在我們可以嘗試向 DeepSeek-R1 提出一個與使用叢集使用者動作模擬系統中的 lib 函數建立 python 腳本相關的問題。

問題:

Help create a python script/function uses the cluster user emulator(CUE) function API to ping an IP 192.168.10.100 and ssh login to the server with (username: admin, password: P@ssword)  to run a command "ifconfig" 

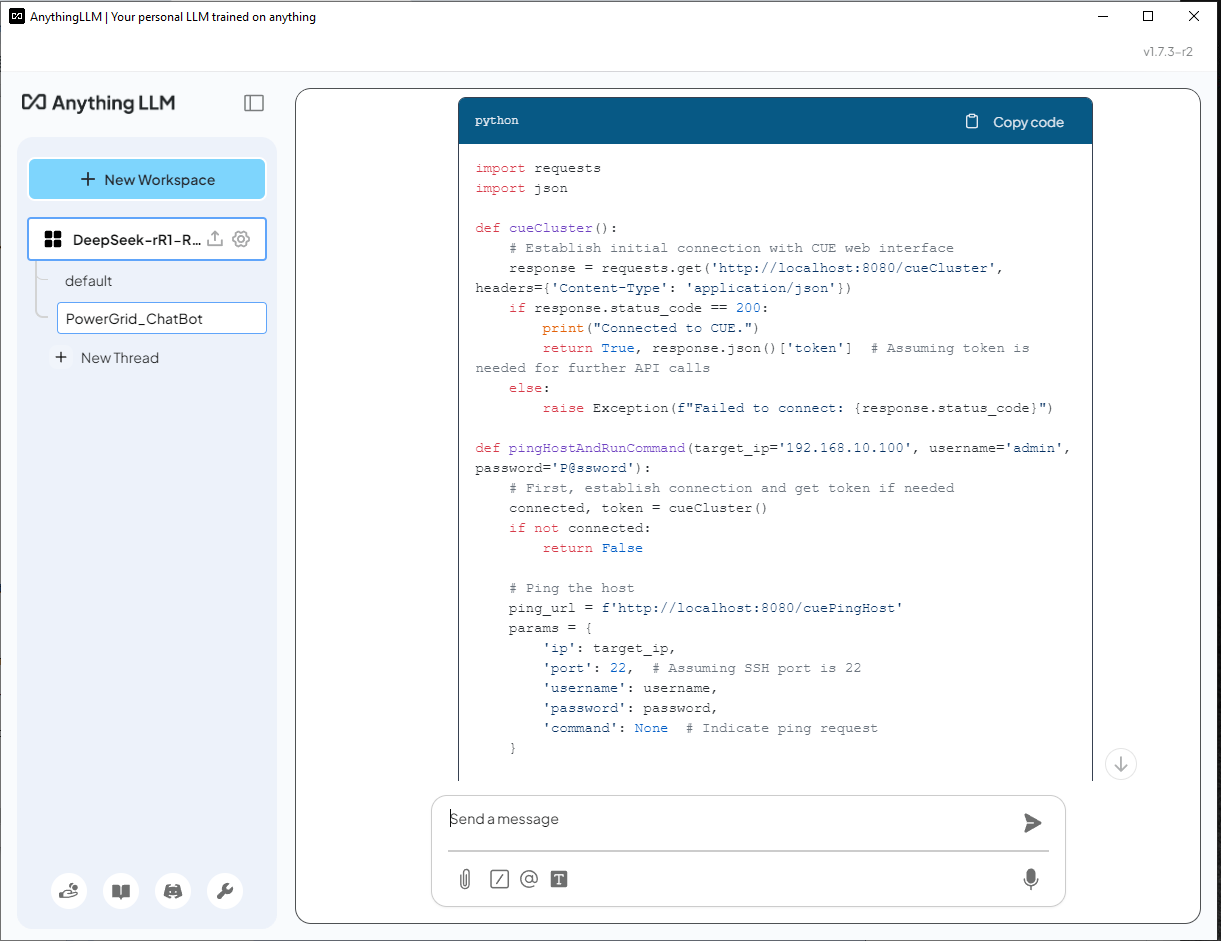
DeepSeek-R1 (Without RAG) 回答 - AI 無法識別 CUE,並錯誤地使用 requests 函式庫產生解決方案,這是錯誤的,如下所示:

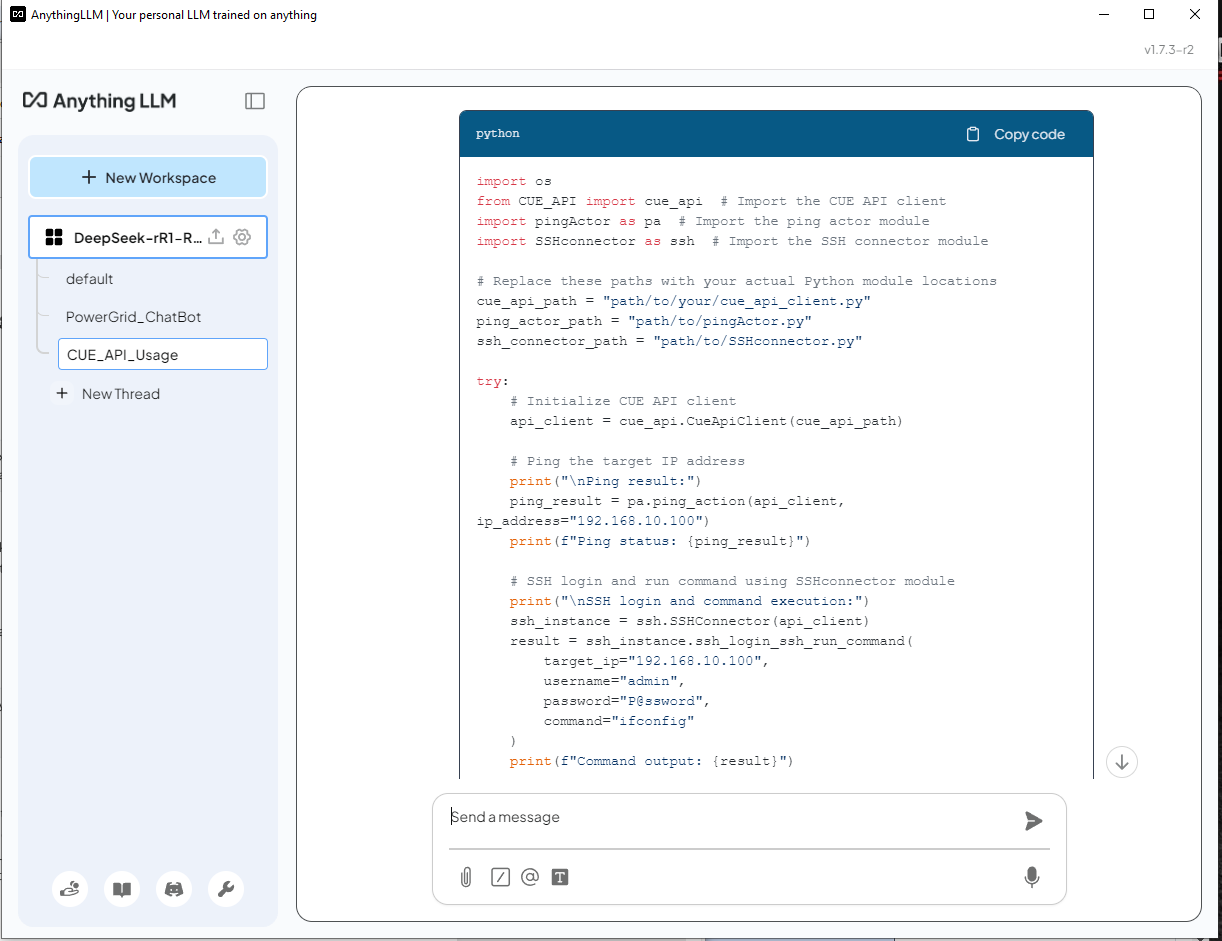
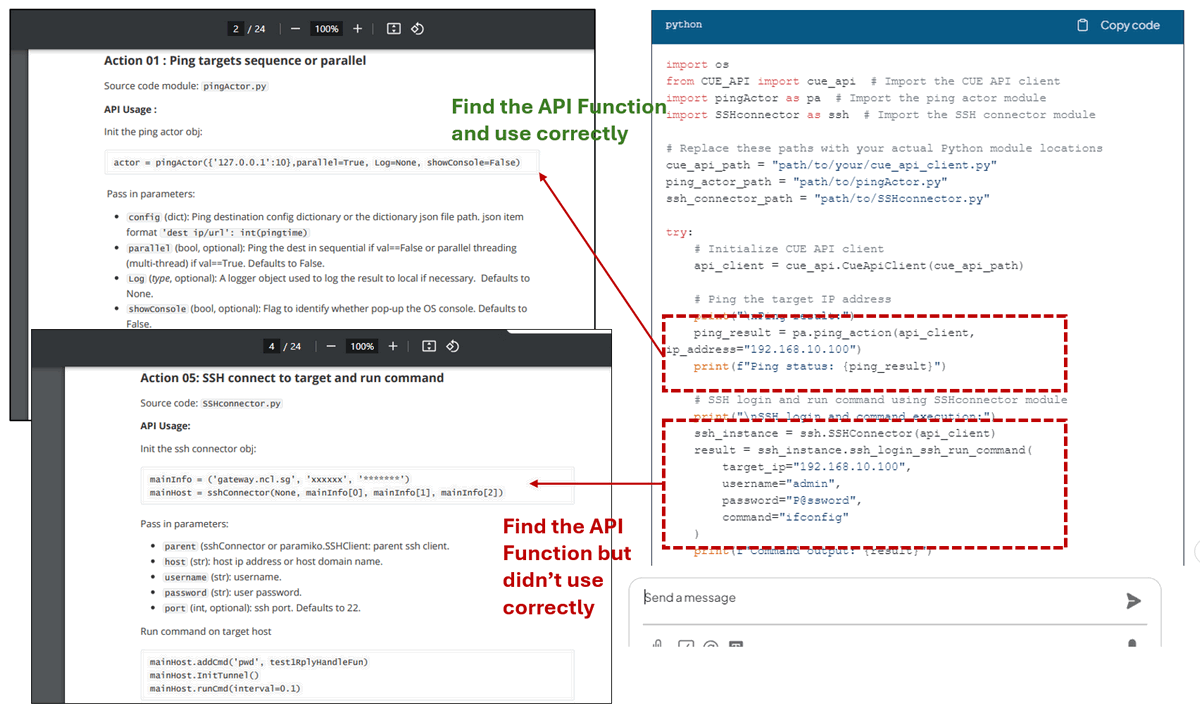
DeepSeek-R1 (啟用 RAG) - AI 正確地利用 CUE API 來產生腳本。但是,雖然它正確地找到了 ping API 函數,但它錯誤地初始化了 SSH 動作:

正如我們所看到的,DeepSeek-R1 使用 API 文件中提供的正確 lib 模組來建構腳本。對於 ping 動作程式碼,它從第 2 頁的 API_document 中找到正確的 API 函數並正確使用。對於 SSH 動作,它從第 4 頁的 API_document 中找到正確的 API,但它沒有正確初始化連接器物件:

啟用 RAG 後,DeepSeek-R1 可以根據特定領域的文件產生回應,使其比標準模型更準確和有用。但是,仍然需要審查 AI 產生的程式碼以確保正確性。


結論

透過自訂 Retrieval-Augmented Generation (RAG) 知識庫在本機部署 DeepSeek-R1,可以實現具有增強的特定領域專業知識且同時保持資料隱私的 AI 驅動應用程式。透過利用 Ollama、nomic-embed-text 和 AnythingLLM 等工具,使用者可以建構針對其獨特需求量身定制的智慧聊天機器人、程式碼產生器和 AI 輔助決策系統。標準 LLM 回應與 RAG 增強答案之間的比較突顯了整合外部知識來源時,準確性和相關性的顯著改進。這種設定不僅提高了 AI 的可靠性,而且確保了專有資料的安全,使其成為企業、研究人員和開發人員尋求本地化 AI 驅動洞察力的強大解決方案。


上次編輯者:LiuYuancheng ([email protected]) 於 2025 年 10 月 02 日編輯,如果您有任何問題,請傳送訊息給我。

  RELATED

  COMMENT

1
Rick Shieh
Apr 25, 2025 at 2:46 pm

Great Introduction! Thank you!


模組名稱 模型類型等級 GPU VRAM CPU RAM 磁碟
deepseek-r1:1.5b 可存取 不需要專用 GPU 或 VRAM CPU 不超過 10 年 8 GB 1.1 GB
deepseek-r1:7b 輕量級 8 GB 的 VRAM 單 CPU,例如 i5 8 GB 4.7 GB
deepseek-r1:8b 輕量級 8 GB 的 VRAM 單 CPU,例如 i5、i7 8 GB 4.9 GB
deepseek-r1:14b 中階 12 - 16 GB 的 VRAM 單 CPU (i7/i9) 或雙 CPU (Xeon Silver 4114 x2) 16-32 GB 9.0 GB
deepseek-r1:32b 中階 24 GB 的 VRAM 雙 CPU (Xeon Silver 4114 x2) 32 - 64 GB 20 GB