
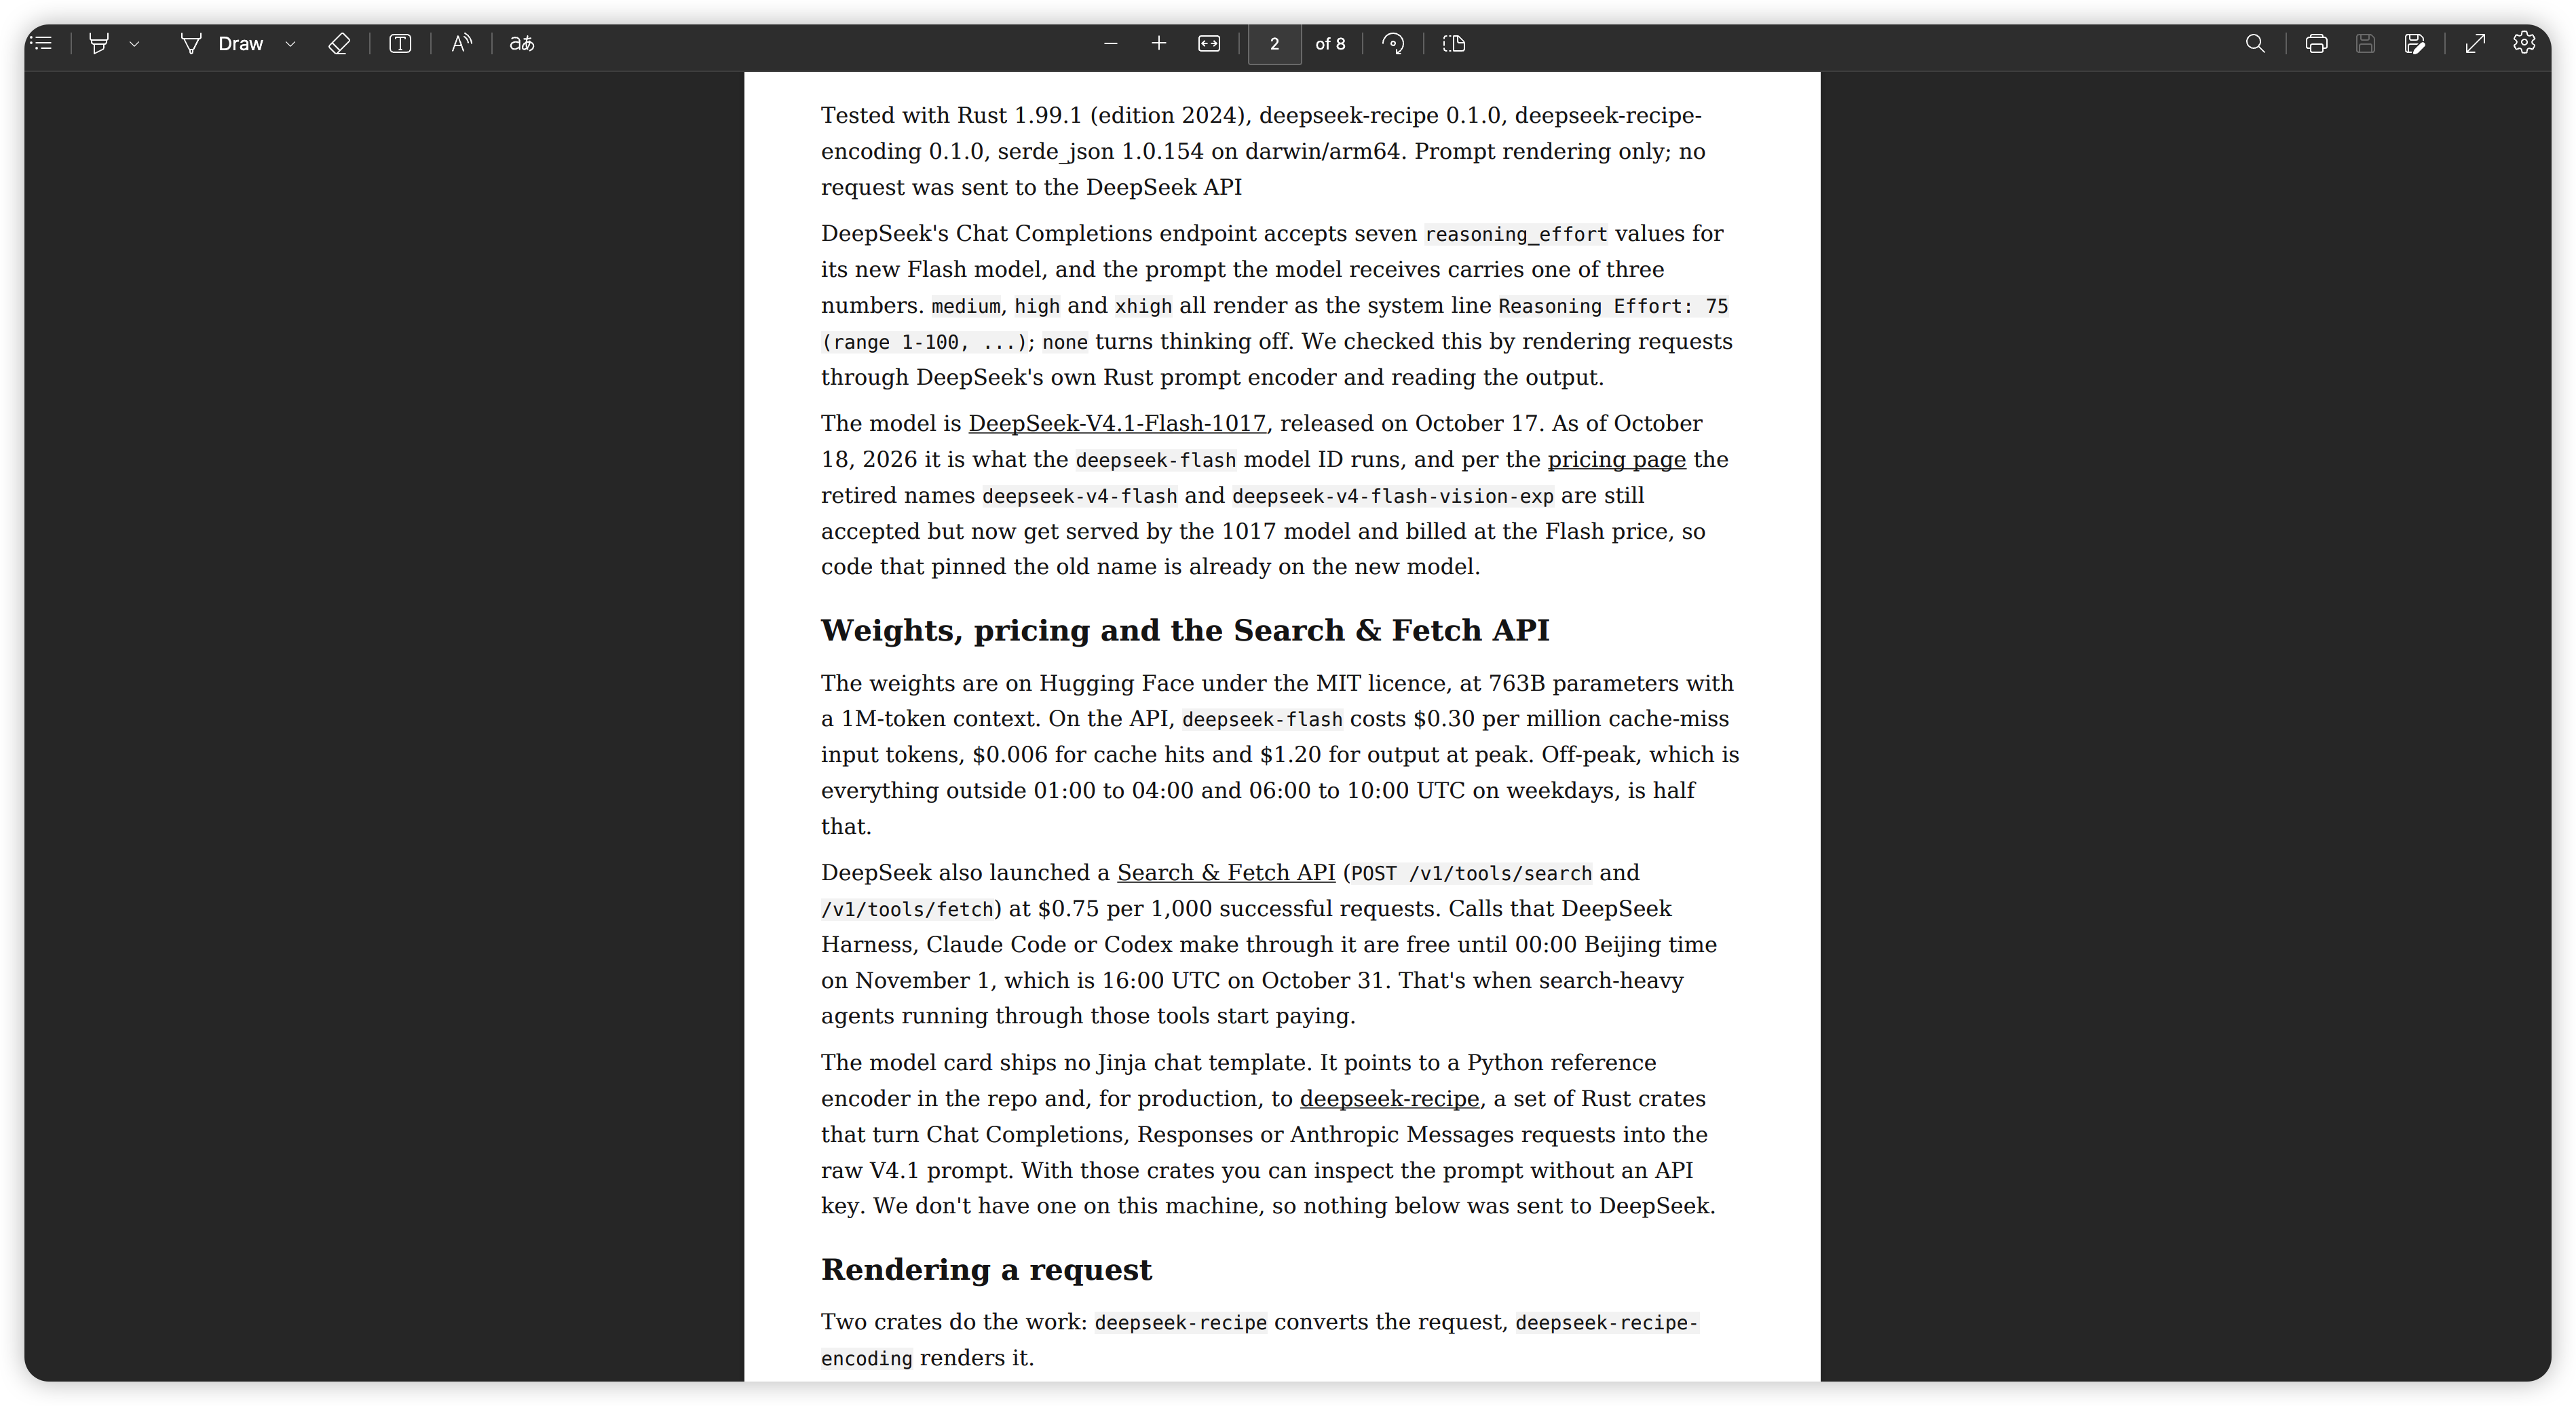
PageSaver 可以通过两种方式将网页保存为 PDF。普通的 另存为 PDF 会保留你看到的页面原样:布局、分栏、图像等等。Reader Mode PDF 则有所不同。它只提取文章本身——标题、作者和正文——并舍弃导航栏、广告、侧边栏、Cookie 横幅、评论区以及分享按钮。你会得到一份干净、可打印的文档,读起来就像书中的一页,而不是一个繁杂网站的截图。
本指南将说明 Reader Mode 的作用、它如何生成 PDF、何时使用它,以及运行它需要什么。我们开发了 PageSaver,这是 PixelsTech 上的浏览器扩展和工具。
Reader Mode PDF 的用途
大多数长篇网页都会用大量其他内容来包裹实际内容。一篇新闻文章可能位于一个同时包含菜单、新闻订阅框、三个广告位、一个“相关故事”栏以及一个浮动视频的页面中。如果你以常规方式保存该页面,所有这些内容都会被一并保存,结果可能难以阅读,打印起来也很浪费。
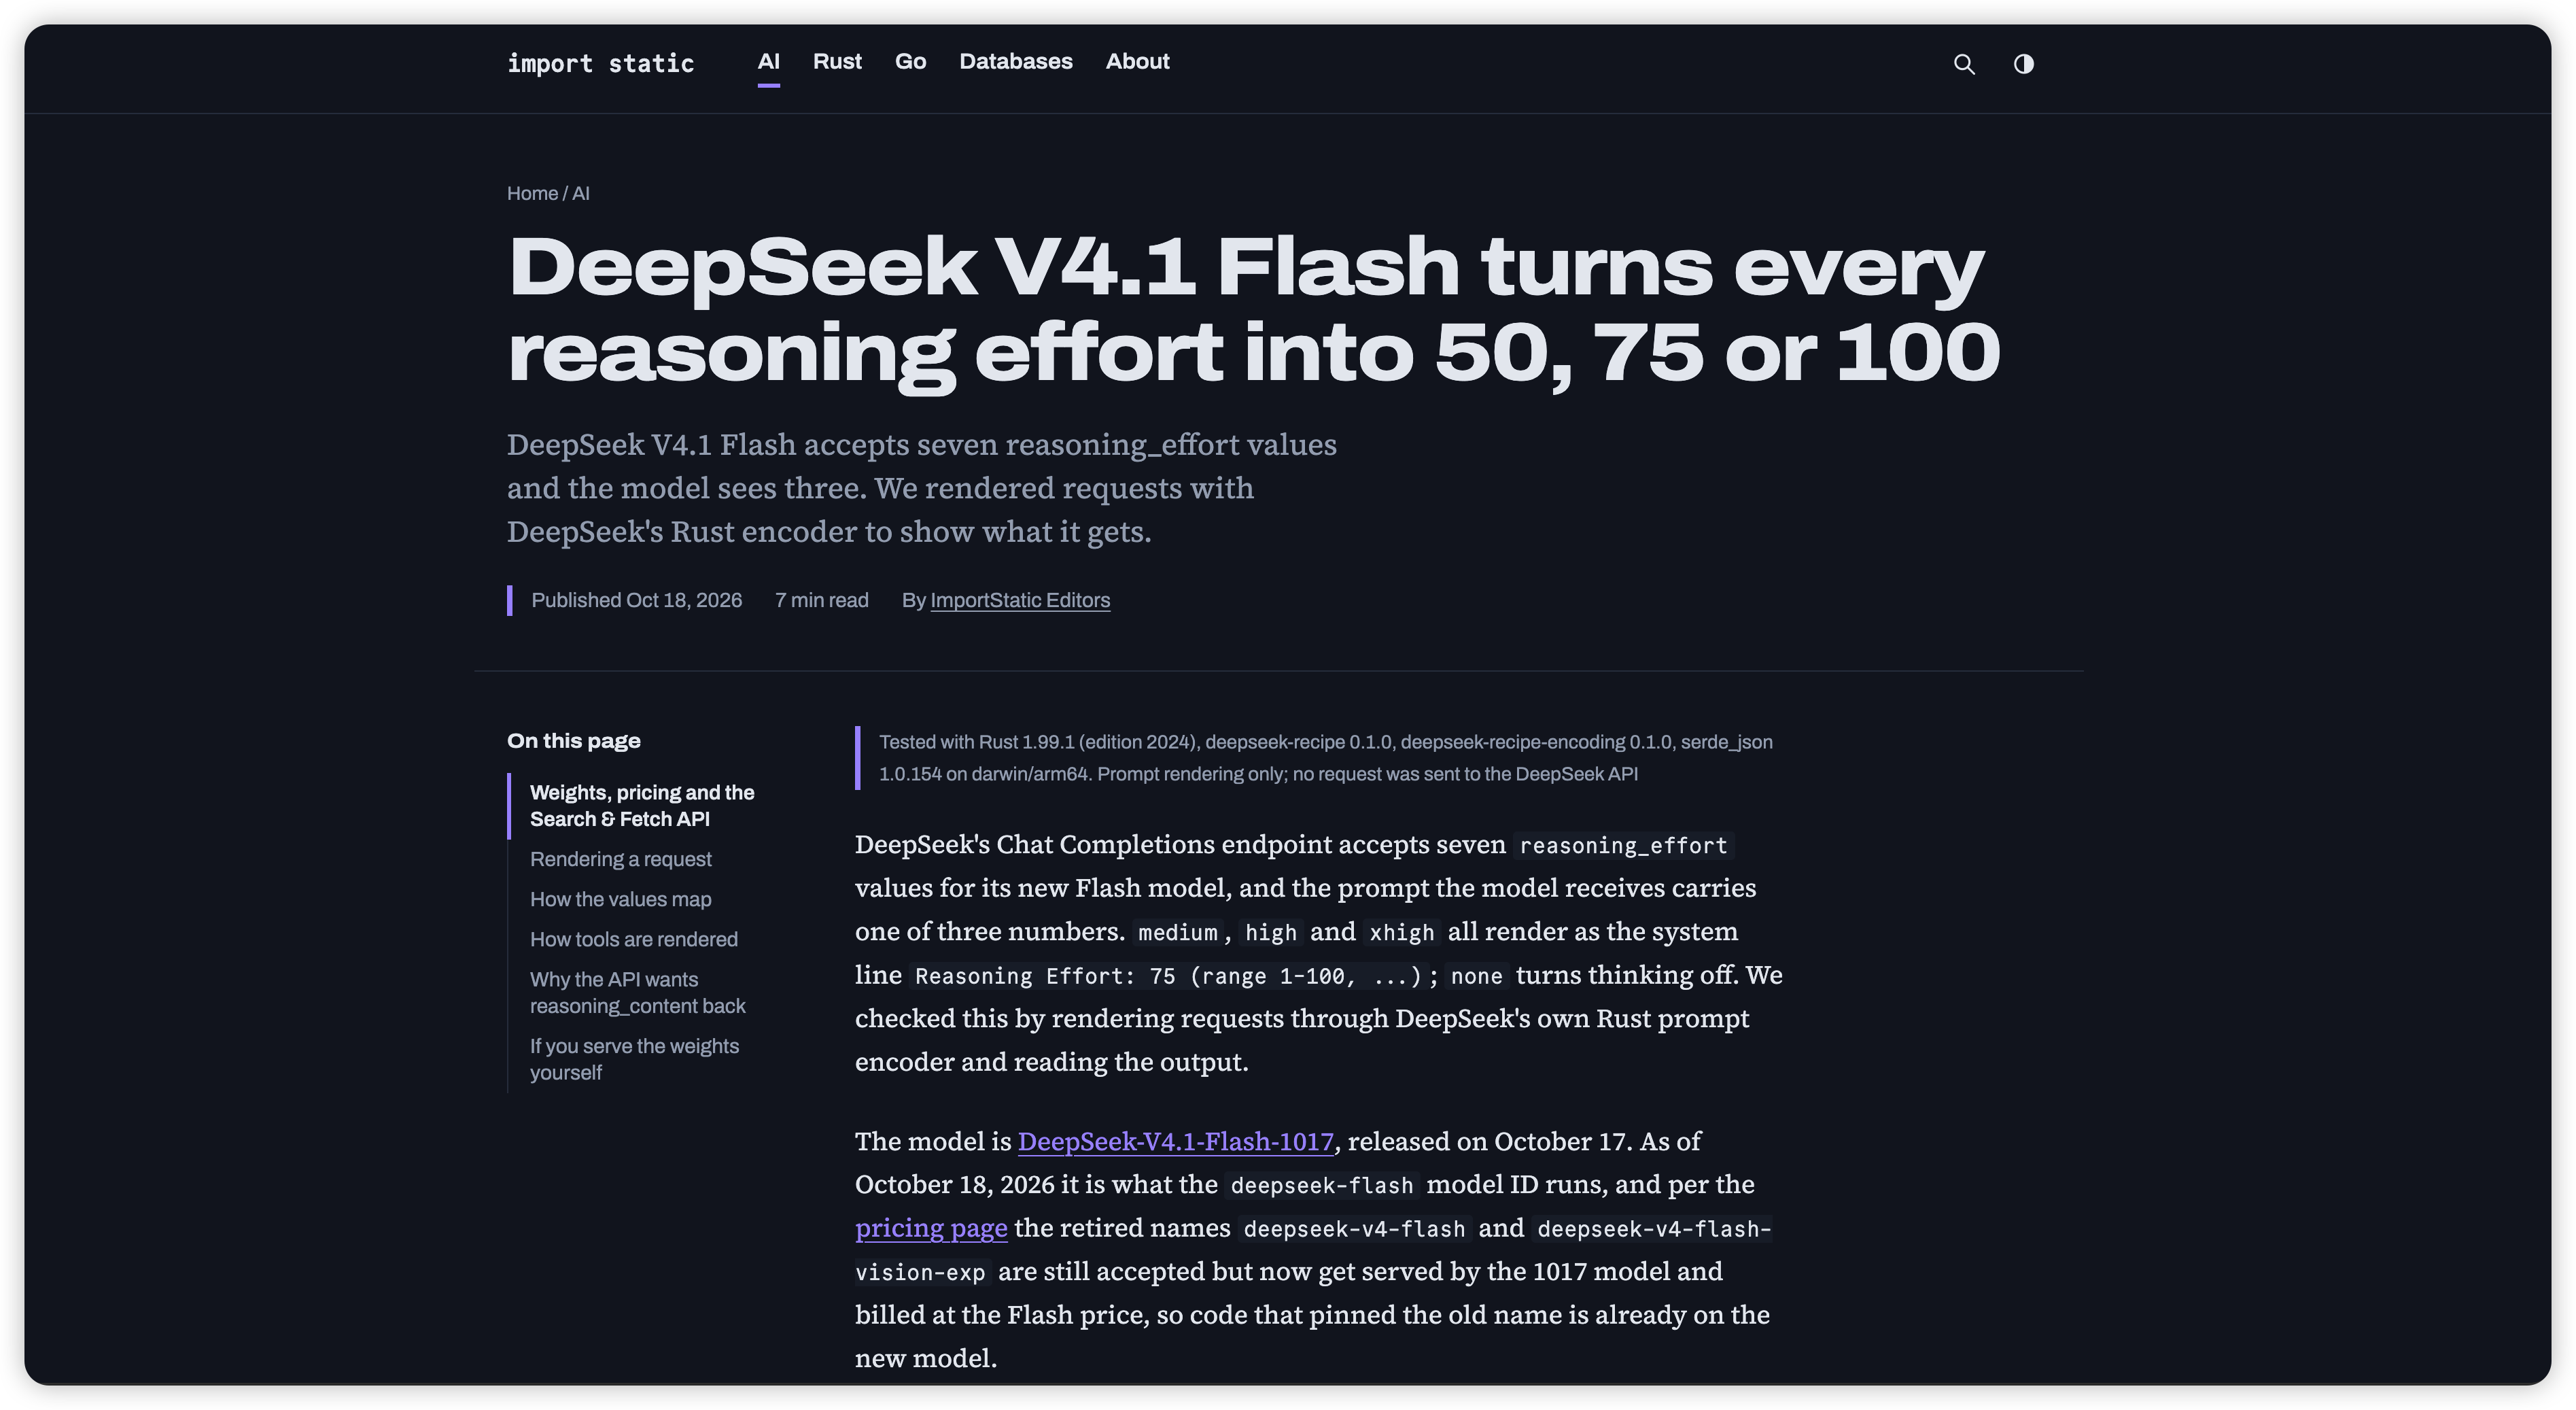
Reader Mode 专为只想要文字内容的场景而设计。它非常适合博客文章、新闻故事、文档、长篇随笔和教程——任何价值在于文章本身的内容。输出是一份整洁的 PDF,你可以稍后阅读、归档、添加注释,或发送给他人,而无需附带周围的杂乱内容。
它如何生成 PDF
Reader Mode 通过几个步骤完成工作,其中大部分步骤会在你触发它的瞬间发生:
- 它会在页面上找到文章。 在你的浏览器中,PageSaver 会执行一次内容提取过程——这与 Firefox 和 Safari 内置的“阅读视图”背后的思路相同,使用的是 Mozilla 的开源 Readability 库。它会识别主标题、已发布的作者(如果有)以及构成故事的文本块,并丢弃页面结构的其余部分。
- 它会清理内容。 提取出的文章会被精简为简单的文档式 HTML:标题、段落、列表、引用、属于该文章的图像以及链接。脚本、跟踪器和页面装饰元素都会被移除。
- 它会渲染出 PDF。 清理后的内容会发送到 PixelsTech,并使用一致的字体、页边距和间距排版成 PDF,因此无论原网站采用何种样式,每个 Reader Mode PDF 看起来都相同。
- 它会添加来源。 文档底部的一行会记录原始页面的链接,因此 PDF 始终可以指回其来源。
由于 PDF 是根据文章的真实文本而非页面图片生成的,因此结果保持可选中和可搜索:你可以复制段落、在文件内搜索,并且文本会干净地重排。
可选附加功能:AI 摘要和编辑
在创建 PDF 之前,可以运行两个可选步骤。
可以在文档顶部添加一段 AI 摘要:一段简短文字,概括文章的要点,放在标题正下方。当你归档大量阅读内容并希望一眼看到要点时,这很有用。你可以在 PageSaver 的设置中开启或关闭此功能。
你也可以选择在内容变成 PDF 之前进行审阅。启用 edit-before-download 后,Reader Mode 会先在编辑器中打开清理后的文章,你可以在其中删减章节、移除图像或修正提取过程中出现的任何错误,然后根据你确认的内容生成最终 PDF。
Reader Mode 不适合使用的情况
Reader Mode 假定页面是一篇文章。对于并非文章的页面——Web 应用、仪表板、产品网格、地图、单页表单或登录屏幕——可供提取的文章式文本可能很少,结果可能显得稀疏或不完整。
PageSaver 会对此进行检查。如果找不到足够的文章式内容,Reader Mode PDF 会在顶部包含一则简短提示,说明该页面可能不适合 Reader Mode,并指引你选择更合适的选项。若要在浏览器中完全按页面显示的样子进行忠实复制,请使用普通的 另存为 PDF,或使用 PageSaver Mac 应用 进行可靠的全页捕获。
一个很好的经验法则是:如果浏览器自带的阅读视图能在某个页面上正常工作,那么 Reader Mode 也可以。如果不能,就改用普通的另存为 PDF。
使用它需要什么
Reader Mode 需要登录 PageSaver 账户。普通的另存为 PDF 不需要,但 Reader Mode 需要,因为 PDF 在 PixelsTech 服务器上生成,并与你的账户绑定。
免费账户可以创建少量 Reader Mode PDF——目前最多五个——因此你可以免费试用并偶尔使用。 付费方案 会取消该限制,让你可以无上限地创建 Reader Mode PDF。普通的 另存为 PDF 和图像保存功能有各自独立的配额,不会消耗你的 Reader Mode 次数。
如何使用
安装 PageSaver 扩展并登录后,打开你想保存的文章,然后通过以下两种方式之一启动 Reader Mode:
- 点击 PageSaver 工具栏图标,然后选择 另存为 PDF(Reader Mode)。
- 或者右键点击页面,然后从 PageSaver 菜单中选择 Reader Mode PDF 选项。
PageSaver 会提取文章,应用你已启用的任何摘要或编辑步骤,并下载完成的 PDF。如果页面最终发现并非文章形态,请阅读文件顶部的提示,并对该页面改用普通的另存为 PDF。
当你想要阅读内容而不是网站本身时,Reader Mode 就是应该选择的选项。对于其他所有情况——完全按渲染结果捕获页面——普通的另存为 PDF 仍然可用。

No comment for this article.