
現今,Redis 已成為網際網路產業中最受歡迎的快取解決方案之一。儘管關聯式資料庫系統 (SQL) 帶來許多很棒的特性,例如 ACID,但為了維持這些特性,資料庫的效能在高負載下會降低。
為了修正這個問題,許多公司和網站已決定在應用程式層(即處理商業邏輯的後端程式碼)和儲存層(即 SQL 資料庫)之間新增快取層。這個快取層通常使用記憶體內快取來實作。這是因為,如同許多教科書所述,傳統 SQL 資料庫的效能瓶頸通常是與輔助儲存裝置(即硬碟)的 I/O。由於過去十年主記憶體 (RAM) 的價格已下降,現在將(至少一部分)資料儲存在主記憶體中以提高效能是可行的。一個受歡迎的選擇是 Redis。
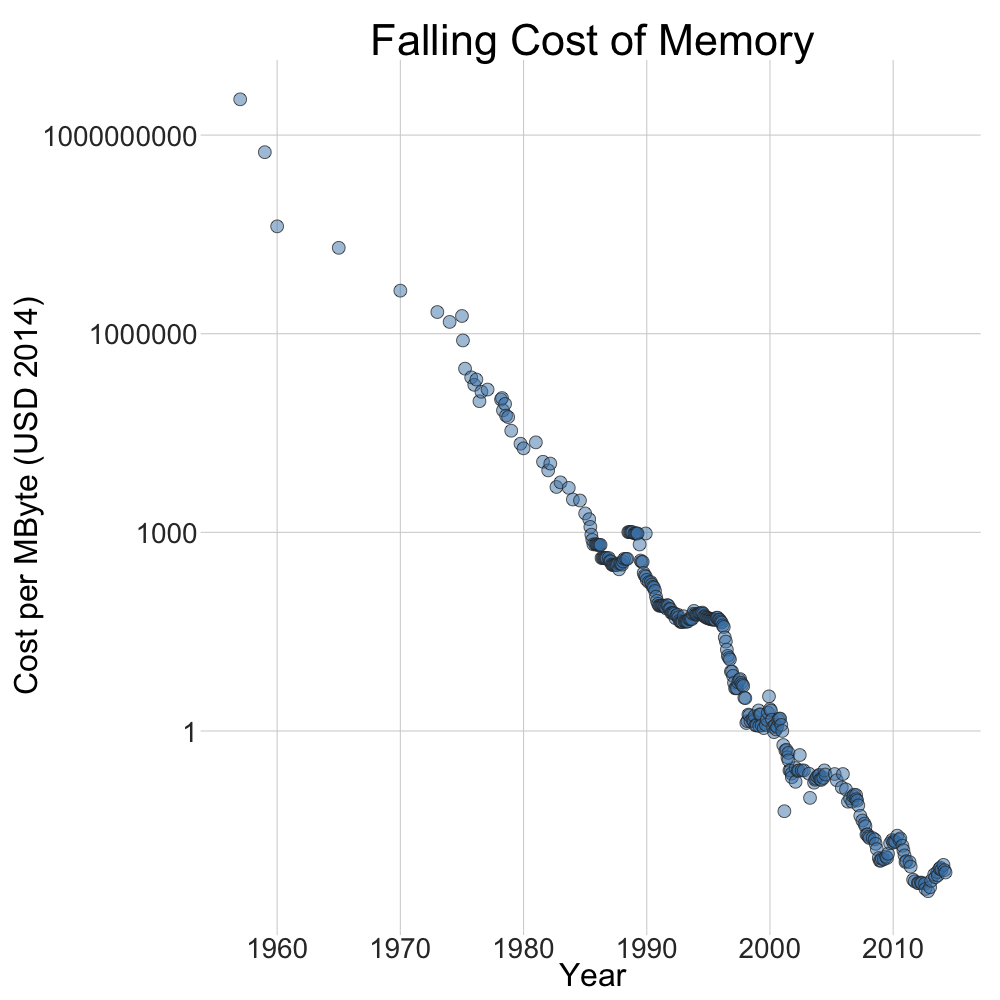
當然,大多數系統只會在快取層(即主記憶體)中儲存所謂的「熱資料」。這是根據帕雷托法則(也稱為 80/20 法則),對於許多事件,大約 80% 的影響來自 20% 的原因。為了符合成本效益,我們只需要在快取層中儲存那 20%。為了識別「熱資料」,我們可以指定一個逐出策略(例如 LFU 或 LRU)來決定要過期哪些資料。
背景
如先前所述,來自 SQL 資料庫的部分資料會儲存在記憶體內快取中,例如 Redis。即使效能有所提升,這種方法也會帶來一個巨大的難題,那就是我們不再有單一的事實來源。現在,相同的資料會儲存在兩個地方。我們如何在避免封鎖的情況下,確保儲存在 Redis 中的資料與儲存在 SQL 資料庫中的資料之間的一致性?
以下,我們將介紹一些常見的錯誤,並指出可能發生的問題。我們還將提出一些解決這個棘手問題的方案。
請注意:為了方便此處的討論,我們以 Redis 和傳統 SQL 資料庫為例。但是,請注意,本文中提出的解決方案可以擴展到其他資料庫,甚至記憶體階層中任何兩層之間的一致性。
各種解決方案
以下我們將描述一些解決這個問題的方法。它們大多數都幾乎正確(但仍然是錯誤的)。換句話說,它們可以在 99.9% 的時間內保證兩層之間的一致性。但是,在高並發和巨大流量下,可能會出錯(例如快取中的髒資料)。
但是,這些幾乎正確的解決方案在業界被廣泛使用,許多公司多年來一直使用這些方法,而沒有出現重大問題。有時,從 99.9% 的正確性到 100% 的正確性太具挑戰性。對於真實世界的業務而言,更快的開發生命週期和更短的上市時間可能更重要。
快取過期
一些天真的解決方案嘗試使用快取過期或保留策略來處理 MySQL 和 Redis 之間的一致性。儘管通常仔細設定 Redis 叢集的過期時間和保留策略是一種很好的做法,但這是一個保證一致性的糟糕解決方案。假設您的快取過期時間為 30 分鐘。您確定您可以承擔長達半小時讀取髒資料的風險嗎?
將過期時間設定得更短呢?假設我們將其設定為 1 分鐘。不幸的是,我們這裡談論的是具有巨大流量和高並發的服務。60 秒可能會讓我們損失數百萬美元。
嗯,讓我們將其設定得更短,5 秒呢?好吧,您確實縮短了不一致的期間。但是,您已經擊敗了使用快取的原始目標!您將會有很多快取未命中,並且系統的效能可能會大幅降低。
快取旁路
快取旁路模式的演算法為:
- 對於不可變的操作(讀取):
- 快取命中:直接從 Redis 傳回資料,不查詢 MySQL;
- 快取未命中:查詢 MySQL 以取得資料(可以使用讀取複本來提高效能),將傳回的資料儲存到 Redis,將結果傳回給用戶端。
- 對於可變的操作(建立、更新、刪除):
- 在 MySQL 中建立、更新或刪除資料;
- 刪除 Redis 中的項目(始終刪除而不是更新快取,新值將在下次快取未命中時插入)。
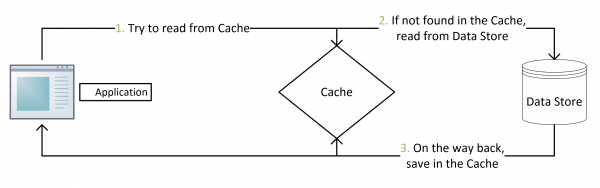
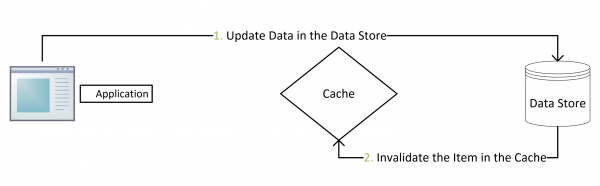
這種方法在大多數情況下都適用。事實上,快取旁路是實作 MySQL 和 Redis 之間一致性的事實標準。著名的論文《在 Facebook 上擴展 Memecache》也描述了這樣的方法。但是,這種方法也確實存在一些問題:
- 在正常情況下(假設程序永遠不會被終止,並且寫入 MySQL/Redis 永遠不會失敗),它大多可以保證最終一致性。假設程序 A 嘗試更新現有值。在某個時刻,A 已成功更新 MySQL 中的值。在它刪除 Redis 中的項目之前,另一個程序 B 嘗試讀取相同的值。然後,B 將會快取命中(因為 Redis 中的項目尚未被刪除)。因此,B 將會讀取過時的值。但是,Redis 中的舊項目最終將被刪除,其他程序最終將會取得更新的值。
- 在極端情況下,它也不能保證最終一致性。讓我們考慮相同的場景。如果程序 A 在嘗試刪除 Redis 中的項目之前被終止,則該舊項目將永遠不會被刪除。因此,之後的所有其他程序將會持續讀取舊值。
- 即使在正常情況下,也存在一個機率非常低的邊緣情況,最終一致性可能會被破壞。假設程序 C 嘗試讀取一個值並快取未命中。然後,C 查詢 MySQL 並取得傳回的結果。突然,C 由於某種原因被作業系統卡住並暫停了一段時間。此時,另一個程序 D 嘗試更新相同的值。D 更新 MySQL 並已刪除 Redis 中的項目。之後,C 恢復並將其查詢結果儲存到 Redis 中。因此,C 將舊值儲存到 Redis 中,並且所有後續程序都將讀取髒資料。這聽起來可能很可怕,但其機率非常低,因為:
- 如果 D 嘗試更新現有值,則當 C 嘗試讀取時,此項目應該存在於 Redis 中。如果 C 快取命中,則不會發生這種情況。為了發生這種情況,該項目必須已過期並已從 Redis 中刪除。但是,如果此項目是「非常熱門的」(即,對其有巨大的讀取流量),則它應該在過期後很快再次儲存到 Redis 中。如果這屬於「冷資料」,則其一致性應該很低,因此很少會同時對此項目發出一個讀取請求和一個更新請求。
- 大多數情況下,寫入 Redis 的速度應該比寫入 MySQL 快得多。實際上,C 對 Redis 的寫入操作應該比 D 對 Redis 的刪除操作早得多。
快取旁路 - 變體 1
快取旁路模式的第 1 個變體的演算法為:
- 對於不可變的操作(讀取):
- 快取命中:直接從 Redis 傳回資料,不查詢 MySQL;
- 快取未命中:查詢 MySQL 以取得資料(可以使用讀取複本來提高效能),將傳回的資料儲存到 Redis,將結果傳回給用戶端。
- 對於可變的操作(建立、更新、刪除):
- 刪除 Redis 中的項目;
- 在 MySQL 中建立、更新或刪除資料。
這可能是一個非常糟糕的解決方案。假設程序 A 嘗試更新現有值。在某個時刻,A 已成功刪除 Redis 中的項目。在 A 更新 MySQL 中的值之前,程序 B 嘗試讀取相同的值並快取未命中。然後,B 查詢 MySQL 並將傳回的資料儲存到 Redis 中。請注意,此時 MySQL 中的資料尚未更新。由於 A 稍後不會再次刪除 Redis 項目,因此舊值將保留在 Redis 中,並且所有後續對此值的讀取都將是錯誤的。
根據以上分析,假設不會發生極端情況,原始快取旁路演算法及其變體 1 在某些情況下都無法保證最終一致性(我們將這種情況稱為不愉快的路徑)。但是,變體 1 的不愉快路徑的機率比原始演算法的機率高得多。
快取旁路 - 變體 2
快取旁路模式的第 2 個變體的演算法為:
- 對於不可變的操作(讀取):
- 快取命中:直接從 Redis 傳回資料,不查詢 MySQL;
- 快取未命中:查詢 MySQL 以取得資料(可以使用讀取複本來提高效能),將傳回的資料儲存到 Redis,將結果傳回給用戶端。
- 對於可變的操作(建立、更新、刪除):
- 在 MySQL 中建立、更新或刪除資料;
- 在 Redis 中建立、更新或刪除項目。
這也是一個糟糕的解決方案。假設有兩個程序 A 和 B 都嘗試更新現有值。A 在 B 之前更新 MySQL;但是,B 在 A 之前更新 Redis 項目。最終,MySQL 中的值由 B 更新;但是,Redis 中的值由 A 更新。這將導致不一致。
同樣,變體 2 的不愉快路徑的機率比原始方法的機率高得多。
讀取穿透
讀取穿透模式的演算法為:
- 對於不可變的操作(讀取):
- 用戶端將始終只從快取讀取。快取命中或快取未命中對用戶端都是透明的。如果是快取未命中,則快取應具有自動從資料庫擷取的能力。
- 對於可變的操作(建立、更新、刪除):
- 此策略不處理可變的操作。它應與寫入穿透(或寫入後)模式結合使用。
讀取穿透模式的一個主要缺點是許多快取層可能不支援它。例如,Redis 將無法自動從 MySQL 擷取(除非您為 Redis 撰寫外掛程式)。
寫入穿透
寫入穿透模式的演算法為:
- 對於不可變的操作(讀取):
- 此策略不處理不可變的操作。它應與讀取穿透模式結合使用。
- 對於可變的操作(建立、更新、刪除):
- 用戶端只需要在 Redis 中建立、更新或刪除項目。快取層必須以原子方式將此變更同步到 MySQL。
寫入穿透模式的缺點也很明顯。首先,許多快取層不會原生支援此功能。其次,Redis 是一個快取,而不是 RDBMS。它並非設計為具有彈性。因此,變更可能會在複寫到 MySQL 之前遺失。即使 Redis 現在已支援 RDB 和 AOF 等持久性技術,也不建議使用此方法。
寫入後
寫入後模式的演算法為:
- 對於不可變的操作(讀取):
- 此策略不處理不可變的操作。它應與讀取穿透模式結合使用。
- 對於可變的操作(建立、更新、刪除):
- 用戶端只需要在 Redis 中建立、更新或刪除項目。快取層將變更儲存到訊息佇列中,並向用戶端傳回成功。變更會非同步複寫到 MySQL,並且可能會在 Redis 向用戶端傳送成功回應後發生。
寫入後模式與寫入穿透模式的不同之處在於,它會非同步地將變更複寫到 MySQL。它提高了輸送量,因為用戶端不必等待複寫發生。具有高持久性的訊息佇列可能是一種可行的實作方式。Redis 串流(自 Redis 5.0 起支援)可能是一個不錯的選擇。為了進一步提高效能,可以合併變更並以批次方式更新 MySQL(以節省查詢次數)。
寫入後模式的缺點類似。首先,許多快取層不原生支援此功能。其次,使用的訊息佇列必須是 FIFO(先進先出)。否則,對 MySQL 的更新可能會順序錯誤,因此最終結果可能不正確。
雙重刪除
雙重刪除模式的演算法為:
- 對於不可變的操作(讀取):
- 快取命中:直接從 Redis 傳回資料,不查詢 MySQL;
- 快取未命中:查詢 MySQL 以取得資料(可以使用讀取複本來提高效能),將傳回的資料儲存到 Redis,將結果傳回給用戶端。
- 對於可變的操作(建立、更新、刪除):
- 刪除 Redis 中的項目;
- 在 MySQL 中建立、更新或刪除資料;
- 休眠一段時間(例如 500 毫秒);
- 再次刪除 Redis 中的項目。
此方法結合了原始快取旁路演算法及其第 1 個變體。由於它是基於原始快取旁路方法的改進,因此我們可以宣告它在正常情況下大多可以保證最終一致性。它也嘗試修正這兩種方法的不愉快路徑。
透過將程序暫停 500 毫秒,該演算法假設所有並發讀取程序都已將舊值儲存到 Redis 中,因此對 Redis 的第二次刪除操作將清除所有髒資料。儘管仍然存在一個邊緣情況,此演算法會破壞最終一致性,但其機率可以忽略不計。
寫入後 - 變體
最後,我們介紹了由中國阿里巴巴集團開發的 canal 專案引入的一種新方法。
這種新方法可以被視為寫入後演算法的變體。但是,它在另一個方向執行複寫。它不是將變更從 Redis 複寫到 MySQL,而是訂閱 MySQL 的 binlog 並將其複寫到 Redis。這提供了比原始演算法更好的持久性和一致性。由於 binlog 是 RDMS 技術的一部分,因此我們可以假設它在災難下是持久且具有彈性的。這種架構也相當成熟,因為它已用於在 MySQL 主伺服器和從伺服器之間複寫變更。
結論
總之,以上任何方法都無法保證強一致性。強一致性也可能不是 Redis 和 MySQL 之間一致性的實際要求。為了保證強一致性,我們必須在所有操作上實作 ACID。這樣做會降低快取層的效能,這將會擊敗我們使用 Redis 快取的目標。
但是,以上所有方法都嘗試實現最終一致性,其中最後一種(由 canal 引入)是最好的。以上某些演算法是對其他一些演算法的改進。為了描述它們的階層,繪製了以下樹狀圖。在圖表中,每個節點通常會比其子節點(如果有的話)實現更好的一致性。
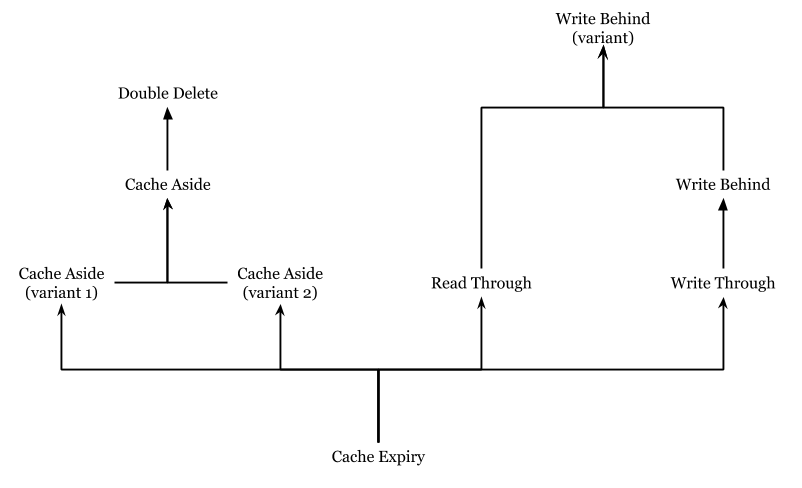
我們得出結論,100% 的正確性和效能之間始終存在權衡。有時,99.9% 的正確性對於真實世界的用例來說已經足夠了。在未來的研究中,我們提醒人們應該記住不要擊敗該主題的原始目標。例如,在討論 MySQL 和 Redis 之間的一致性時,我們不能犧牲效能。
參考文獻
注意:這篇文章已獲得原作者 Yunpeng Niu(一位優秀的 NUS CS 學生)授權在此處重新發布。若要閱讀他更多文章,請造訪 https://yunpengn.github.io/blog/

Great article! really helped me out understanding a correct workflow :)