
如今,Redis 已成为互联网行业中最流行的缓存解决方案之一。虽然关系数据库系统 (SQL) 带来了许多出色的特性,例如 ACID,但为了维护这些特性,数据库的性能在高负载下会下降。
为了解决这个问题,许多公司和网站决定在应用层(即处理业务逻辑的后端代码)和存储层(即 SQL 数据库)之间添加一个缓存层。这个缓存层通常使用内存缓存来实现。这是因为,正如许多教科书中所述,传统 SQL 数据库的性能瓶颈通常是到辅助存储(即硬盘)的 I/O。由于过去十年中主内存 (RAM) 的价格下降,现在将(至少部分)数据存储在主内存中以提高性能是可行的。一个流行的选择是 Redis。
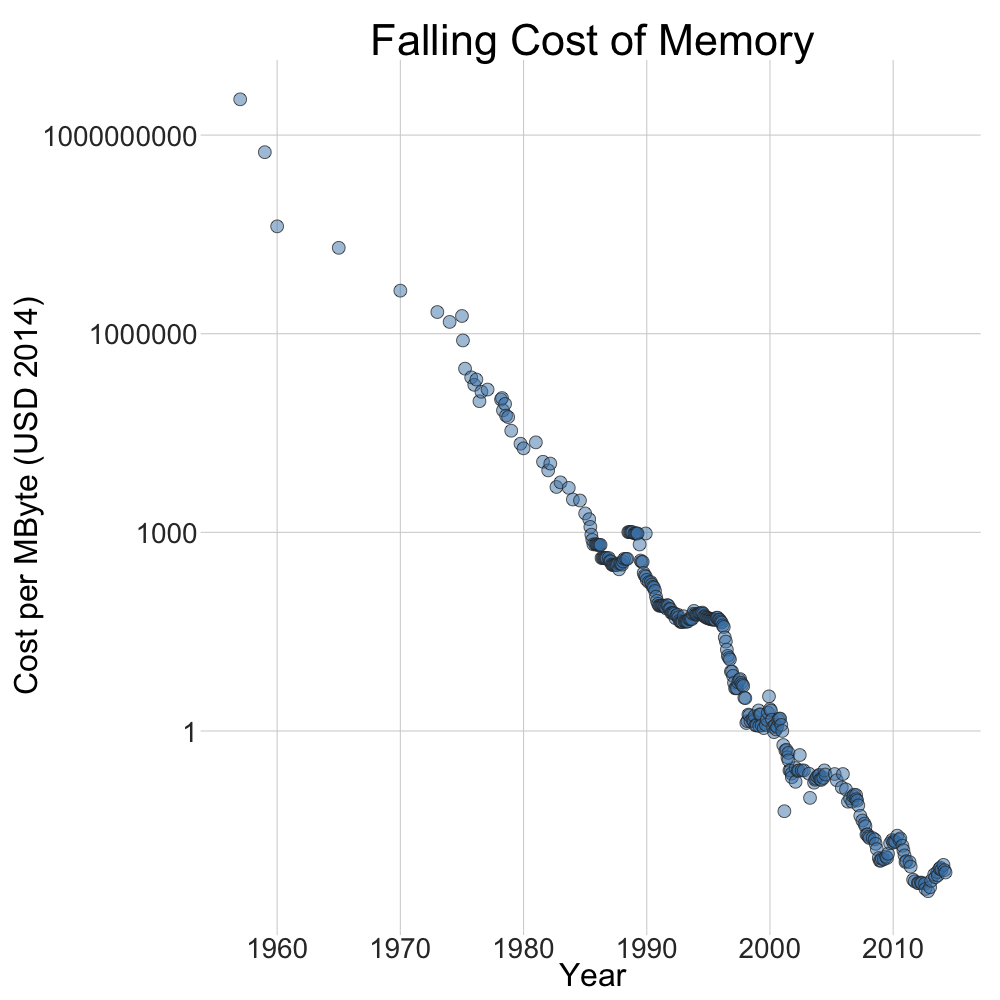
当然,大多数系统只会将所谓的“热数据”存储在缓存层(即主内存)中。这符合帕累托原则(也称为 80/20 法则),对于许多事件,大约 80% 的影响来自 20% 的原因。为了提高成本效益,我们只需要将这 20% 存储在缓存层中。为了识别“热数据”,我们可以指定一个驱逐策略(例如 LFU 或 LRU)来确定要过期哪些数据。
背景
如前所述,来自 SQL 数据库的部分数据将存储在内存缓存中,例如 Redis。即使性能得到了提高,这种方法也会带来一个巨大的难题,即我们不再拥有单一的事实来源。现在,同一条数据将存储在两个地方。我们如何在避免阻塞的同时,确保存储在 Redis 中的数据和存储在 SQL 数据库中的数据之间的一致性?
下面,我们列出一些常见的错误,并指出可能出现的问题。我们还提出了解决这个棘手问题的一些方案。
注意:为了方便我们在此处的讨论,我们以 Redis 和传统 SQL 数据库为例。但是,请注意,本文中提出的解决方案可以扩展到其他数据库,甚至内存层次结构中任意两层之间的一致性。
各种解决方案
下面我们描述几种解决这个问题的方法。它们中的大多数都是几乎正确的(但仍然是错误的)。换句话说,它们可以在 99.9% 的时间内保证两层之间的一致性。但是,在高并发和巨大流量下,可能会出现问题(例如缓存中的脏数据)。
然而,这些几乎正确的解决方案在行业中被广泛使用,许多公司多年来一直在使用这些方法,而没有出现重大问题。有时,从 99.9% 的正确性到 100% 的正确性太具有挑战性。对于现实世界的业务而言,更快的开发生命周期和更短的上市时间可能更重要。
缓存过期
一些幼稚的解决方案试图使用缓存过期或保留策略来处理 MySQL 和 Redis 之间的一致性。虽然通常来说,为您的 Redis 集群仔细设置过期时间和保留策略是一个好习惯,但这对于保证一致性来说是一个糟糕的解决方案。假设您的缓存过期时间为 30 分钟。您确定可以承担读取长达半小时的脏数据的风险吗?
将过期时间设置得更短怎么样?假设我们将其设置为 1 分钟。不幸的是,我们这里讨论的是具有巨大流量和高并发的服务。60 秒可能会让我们损失数百万美元。
嗯,让我们将其设置得更短,5 秒怎么样?好吧,您确实缩短了不一致的时期。但是,您已经违背了使用缓存的初衷!您将会有大量的缓存未命中,并且系统的性能可能会大大降低。
缓存旁路
缓存旁路模式的算法是:
- 对于不可变操作(读取):
- 缓存命中:直接从 Redis 返回数据,无需查询 MySQL;
- 缓存未命中:查询 MySQL 以获取数据(可以使用读取副本以提高性能),将返回的数据保存到 Redis,将结果返回给客户端。
- 对于可变操作(创建、更新、删除):
- 创建、更新或删除 MySQL 中的数据;
- 删除 Redis 中的条目(始终删除而不是更新缓存,新值将在下次缓存未命中时插入)。
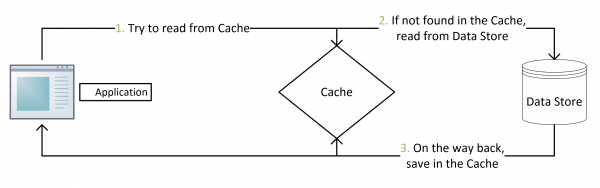
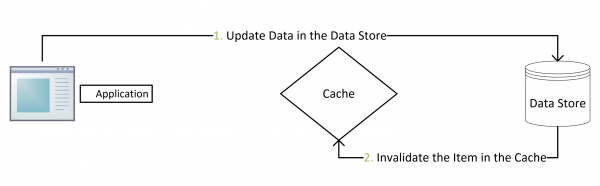
这种方法在大多数情况下都适用。事实上,缓存旁路是实现 MySQL 和 Redis 之间一致性的事实标准。著名的论文《在 Facebook 上扩展 Memecache》也描述了这种方法。但是,这种方法也存在一些问题:
- 在正常情况下(假设进程永远不会被杀死,并且写入 MySQL/Redis 永远不会失败),它基本上可以保证最终一致性。假设进程 A 尝试更新现有值。在某一时刻,A 已成功更新 MySQL 中的值。在它删除 Redis 中的条目之前,另一个进程 B 尝试读取相同的值。B 将获得缓存命中(因为 Redis 中的条目尚未被删除)。因此,B 将读取过时的值。但是,Redis 中的旧条目最终将被删除,其他进程最终将获得更新后的值。
- 在极端情况下,它也不能保证最终一致性。让我们考虑相同的场景。如果进程 A 在尝试删除 Redis 中的条目之前被杀死,则该旧条目将永远不会被删除。因此,此后的所有其他进程都将继续读取旧值。
- 即使在正常情况下,也存在一种概率非常低的极端情况,即最终一致性可能会被破坏。假设进程 C 尝试读取一个值并获得缓存未命中。然后 C 查询 MySQL 并获得返回的结果。突然,C 由于某种原因被操作系统卡住并暂停了一段时间。此时,另一个进程 D 尝试更新相同的值。D 更新 MySQL 并删除了 Redis 中的条目。之后,C 恢复并将其查询结果保存到 Redis 中。因此,C 将旧值保存到 Redis 中,并且所有后续进程都将读取脏数据。这听起来可能很可怕,但它的概率非常低,因为:
- 如果 D 尝试更新现有值,则当 C 尝试读取该值时,该条目应该存在于 Redis 中。如果 C 获得缓存命中,则不会发生这种情况。为了发生这种情况,该条目必须已过期并已从 Redis 中删除。但是,如果此条目是“非常热”的(即,对其有巨大的读取流量),则它应该在过期后很快再次保存到 Redis 中。如果这属于“冷数据”,则其一致性应该很低,因此很少会同时对该条目发出一个读取请求和一个更新请求。
- 通常,写入 Redis 的速度应该比写入 MySQL 的速度快得多。实际上,C 对 Redis 的写入操作应该比 D 对 Redis 的删除操作发生得早得多。
缓存旁路 - 变体 1
缓存旁路模式的第一个变体的算法是:
- 对于不可变操作(读取):
- 缓存命中:直接从 Redis 返回数据,无需查询 MySQL;
- 缓存未命中:查询 MySQL 以获取数据(可以使用读取副本以提高性能),将返回的数据保存到 Redis,将结果返回给客户端。
- 对于可变操作(创建、更新、删除):
- 删除 Redis 中的条目;
- 创建、更新或删除 MySQL 中的数据。
这可能是一个非常糟糕的解决方案。假设进程 A 尝试更新现有值。在某一时刻,A 已成功删除 Redis 中的条目。在 A 更新 MySQL 中的值之前,进程 B 尝试读取相同的值并获得缓存未命中。然后,B 查询 MySQL 并将返回的数据保存到 Redis 中。请注意,此时 MySQl 中的数据尚未更新。由于 A 稍后不会再次删除 Redis 条目,因此旧值将保留在 Redis 中,并且所有后续对此值的读取都将是错误的。
根据以上分析,假设不会发生极端情况,原始缓存旁路算法及其变体 1 在某些情况下都不能保证最终一致性(我们称这种情况为“不愉快路径”)。但是,变体 1 的不愉快路径的概率比原始算法的概率高得多。
缓存旁路 - 变体 2
缓存旁路模式的第二个变体的算法是:
- 对于不可变操作(读取):
- 缓存命中:直接从 Redis 返回数据,无需查询 MySQL;
- 缓存未命中:查询 MySQL 以获取数据(可以使用读取副本以提高性能),将返回的数据保存到 Redis,将结果返回给客户端。
- 对于可变操作(创建、更新、删除):
- 创建、更新或删除 MySQL 中的数据;
- 创建、更新或删除 Redis 中的条目。
这也是一个糟糕的解决方案。假设有两个进程 A 和 B 都尝试更新现有值。A 在 B 之前更新 MySQL;但是,B 在 A 之前更新 Redis 条目。最终,MySQL 中的值由 B 更新;但是,Redis 中的值由 A 更新。这将导致不一致。
同样,变体 2 的不愉快路径的概率比原始方法的概率高得多。
读取穿透
读取穿透模式的算法是:
- 对于不可变操作(读取):
- 客户端将始终简单地从缓存中读取。缓存命中或缓存未命中对客户端是透明的。如果是缓存未命中,则缓存应具有自动从数据库中获取数据的能力。
- 对于可变操作(创建、更新、删除):
- 此策略不处理可变操作。它应与写入穿透(或写入后置)模式结合使用。
读取穿透模式的一个主要缺点是许多缓存层可能不支持它。例如,Redis 将无法自动从 MySQL 中获取数据(除非您为 Redis 编写插件)。
写入穿透
写入穿透模式的算法是:
- 对于不可变操作(读取):
- 此策略不处理不可变操作。它应与读取穿透模式结合使用。
- 对于可变操作(创建、更新、删除):
- 客户端只需要在 Redis 中创建、更新或删除条目。缓存层必须以原子方式将此更改同步到 MySQL。
写入穿透模式的缺点也很明显。首先,许多缓存层本身不支持此功能。其次,Redis 是缓存而不是 RDBMS。它并非设计为具有弹性。因此,更改可能会在复制到 MySQL 之前丢失。即使 Redis 现在支持 RDB 和 AOF 等持久性技术,也不建议使用此方法。
写入后置
写入后置模式的算法是:
- 对于不可变操作(读取):
- 此策略不处理不可变操作。它应与读取穿透模式结合使用。
- 对于可变操作(创建、更新、删除):
- 客户端只需要在 Redis 中创建、更新或删除条目。缓存层将更改保存到消息队列中,并向客户端返回成功。更改会异步复制到 MySQL,并且可能会在 Redis 向客户端发送成功响应后发生。
写入后置模式与写入穿透模式的不同之处在于,它会异步地将更改复制到 MySQL。它提高了吞吐量,因为客户端不必等待复制发生。具有高持久性的消息队列可能是一种可行的实现方式。Redis 流(自 Redis 5.0 起支持)可能是一个不错的选择。为了进一步提高性能,可以将更改合并并批量更新 MySQL(以节省查询次数)。
写入后置模式的缺点类似。首先,许多缓存层本身不支持此功能。其次,使用的消息队列必须是 FIFO(先进先出)。否则,对 MySQL 的更新可能会乱序,从而导致最终结果不正确。
双重删除
双重删除模式的算法是:
- 对于不可变操作(读取):
- 缓存命中:直接从 Redis 返回数据,无需查询 MySQL;
- 缓存未命中:查询 MySQL 以获取数据(可以使用读取副本以提高性能),将返回的数据保存到 Redis,将结果返回给客户端。
- 对于可变操作(创建、更新、删除):
- 删除 Redis 中的条目;
- 创建、更新或删除 MySQL 中的数据;
- 休眠一段时间(例如 500 毫秒);
- 再次删除 Redis 中的条目。
此方法结合了原始缓存旁路算法及其第一个变体。由于它是基于原始缓存旁路方法的改进,因此我们可以声明它在正常情况下基本上可以保证最终一致性。它还试图修复这两种方法的不愉快路径。
通过将进程暂停 500 毫秒,该算法假设所有并发读取进程都已将旧值保存到 Redis 中,因此对 Redis 的第二次删除操作将清除所有脏数据。尽管仍然存在此算法会破坏最终一致性的极端情况,但其概率可以忽略不计。
写入后置 - 变体
最后,我们介绍一个由中国阿里巴巴集团开发的 canal 项目引入的新方法。
这种新方法可以被视为 写入后置 算法的变体。但是,它在另一个方向执行复制。它不是将更改从 Redis 复制到 MySQL,而是订阅 MySQL 的 binlog 并将其复制到 Redis。这比原始算法提供了更好的持久性和一致性。由于 binlog 是 RDMS 技术的一部分,因此我们可以假设它在灾难下是持久且有弹性的。这种架构也相当成熟,因为它已被用于在 MySQL 主服务器和从服务器之间复制更改。
结论
总之,以上任何方法都不能保证强一致性。强一致性对于 Redis 和 MySQL 之间的一致性来说可能也不是一个现实的要求。为了保证强一致性,我们必须在所有操作上实现 ACID。这样做会降低缓存层的性能,这将违背我们使用 Redis 缓存的目标。
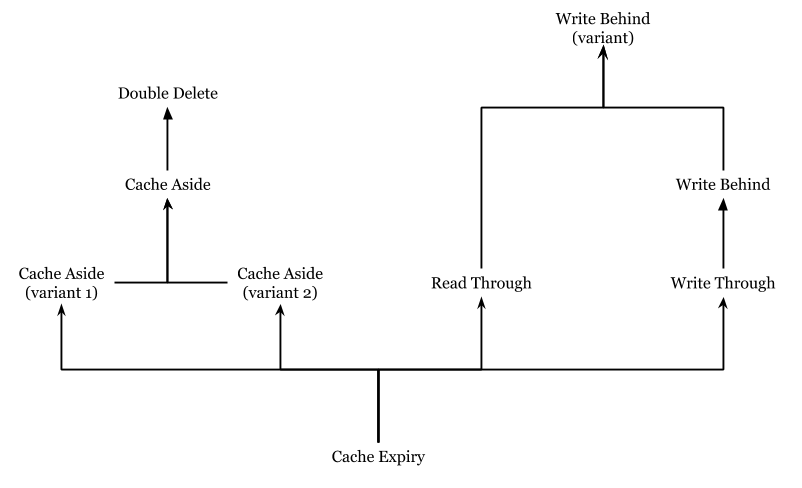
但是,以上所有方法都试图实现最终一致性,其中最后一种(由 canal 引入)是最好的。以上一些算法是对其他一些算法的改进。为了描述它们的层次结构,绘制了以下树状图。在图中,每个节点通常会比其子节点(如果有)实现更好的一致性。
我们得出结论,100% 的正确性和性能之间总是会存在权衡。有时,99.9% 的正确性对于现实世界的用例来说已经足够了。在未来的研究中,我们提醒人们应该记住不要违背该主题的最初目标。例如,在讨论 MySQL 和 Redis 之间的一致性时,我们不能牺牲性能。
参考资料
注意:这篇文章已获得原作者 Yunpeng Niu(一位优秀的 NUS CS 学生)的授权,可以在此处重新发布。要阅读他更多的文章,请访问 https://yunpengn.github.io/blog/

Great article! really helped me out understanding a correct workflow :)