
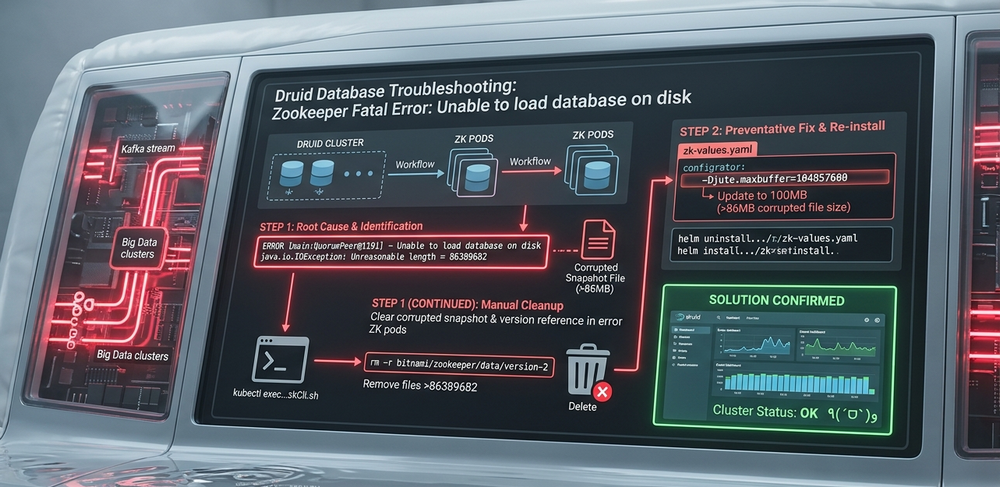
本文將介紹解決 Druid Database Kafka Zookeeper 中發生的「unable to load data base on disk」問題的詳細步驟。
#作者:      Yuancheng Liu
#創建日期:     2022/10/12
#版本:     v_0.0.1
#版權:   Copyright (c) LiuYuancheng
1. 背景介紹
Apache Druid 是一個開源的分佈式資料儲存,專為高效能即時分析而設計。它結合了資料倉儲、時間序列資料庫和搜尋系統的概念,使其成為大型資料視覺化平台的熱門選擇。在許多部署中,Apache Kafka 被用作 Druid 的串流攝取管道,實現資料的持續流入系統。
2. 問題概述
在運行期間,您的 Druid 叢集可能會遇到一個關鍵問題:
ZooKeeper error: “Unable to load database on disk”
這通常在以下情況下發生:
-
大量串流資料在短時間內被攝取
-
一個或多個資料節點在攝取期間離線
-
恢復後,一個或多個 Apache ZooKeeper pod 無法正常啟動
即使在重新啟動 pod、重新部署 ZooKeeper 或重新安裝組件後,問題仍然存在。詳細的 pod 錯誤訊息如下所示:
2022-05-08 14:30:34,798 [myid:5] - INFO  [main:ZKAuditProvider@42] - ZooKeeper audit is disabled
2022-05-08 14:30:34,801 [myid:5] - ERROR [main:QuorumPeer@1191] - Unable to load database on disk
java.io.IOException: Unreasonable length = 86389682
	at org.apache.jute.BinaryInputArchive.checkLength(BinaryInputArchive.java:166)
	at org.apache.jute.BinaryInputArchive.readBuffer(BinaryInputArchive.java:127)
	at org.apache.zookeeper.server.persistence.Util.readTxnBytes(Util.java:159)
	at org.apache.zookeeper.server.persistence.FileTxnLog$FileTxnIterator.next(FileTxnLog.java:749)
	at org.apache.zookeeper.server.persistence.FileTxnSnapLog.fastForwardFromEdits(FileTxnSnapLog.java:361)
	at org.apache.zookeeper.server.persistence.FileTxnSnapLog.lambda$restore$0(FileTxnSnapLog.java:267)
	at org.apache.zookeeper.server.persistence.FileTxnSnapLog.restore(FileTxnSnapLog.java:312)
	at org.apache.zookeeper.server.ZKDatabase.loadDataBase(ZKDatabase.java:286)
	at org.apache.zookeeper.server.quorum.QuorumPeer.loadDataBase(QuorumPeer.java:1145)
	at org.apache.zookeeper.server.quorum.QuorumPeer.start(QuorumPeer.java:1130)
	at org.apache.zookeeper.server.quorum.QuorumPeerMain.runFromConfig(QuorumPeerMain.java:229)
	at org.apache.zookeeper.server.quorum.QuorumPeerMain.initializeAndRun(QuorumPeerMain.java:137)
	at org.apache.zookeeper.server.quorum.QuorumPeerMain.main(QuorumPeerMain.java:91)
2022-05-08 14:30:34,803 [myid:5] - ERROR [main:QuorumPeerMain@114] - Unexpected exception, exiting abnormally
java.lang.RuntimeException: Unable to run quorum server
	at org.apache.zookeeper.server.quorum.QuorumPeer.loadDataBase(QuorumPeer.java:1192)
	at org.apache.zookeeper.server.quorum.QuorumPeer.start(QuorumPeer.java:1130)
	at org.apache.zookeeper.server.quorum.QuorumPeerMain.runFromConfig(QuorumPeerMain.java:229)
	at org.apache.zookeeper.server.quorum.QuorumPeerMain.initializeAndRun(QuorumPeerMain.java:137)
	at org.apache.zookeeper.server.quorum.QuorumPeerMain.main(QuorumPeerMain.java:91).
3. 問題分析
3.1 根本原因分析
這個問題通常是由 ZooKeeper 中損壞或過大的快照/事務日誌檔案引起的。
主要影響因素:
-
負載沉重的 Druid 歷史節點從 ZooKeeper 請求大量段元資料
-
節點故障期間產生損壞的快照或事務日誌
-
ZooKeeper 持久化這些快照以避免資料丟失
-
損壞的快照會傳播回健康的或新建立的 ZooKeeper pod
結果是:
-
ZooKeeper pod 在啟動期間反覆失敗
-
叢集可能失去仲裁(≥50% 故障),導致服務完全中斷
-
單獨重新安裝無法解決問題,因為損壞的資料會被重新引入
3.2 手動清理的挑戰
手動修復這個問題很困難,因為:
-
損壞的檔案可能存在於多個歷史節點上
-
在一個節點上清理可能會觸發資料複製到另一個節點
-
系統會持續嘗試保留和重新分發快照資料
4. 詳細解決方案
為了有效解決這個問題,需要採取兩個行動:
-
移除損壞的 ZooKeeper 快照檔案和版本參考
-
增加 ZooKeeper 緩衝區大小 (
Djute.maxbuffer)
4.1 步驟 1:清理 ZooKeeper Pod 中的損壞快照
-
存取 ZooKeeper CLI:
kubectl exec -it druid-cluster-zk-zookeeper- -- zkCli.sh-
重新啟動受影響的 ZooKeeper pod
-
如果 pod 停留在等待狀態,請重新啟動它並在初始化期間執行清理
-
-
移除損壞的資料檔案:
rm -r /bitnami/zookeeper/data/version-2-
刪除過大的快照檔案:
-
識別超出錯誤中報告大小(例如,
86389682)的快照檔案 -
手動移除這些檔案:
rm snapshot.*✅ 至此,ZooKeeper 資料目錄已清理乾淨。
⚠️ Important: If you skip this step, corrupted snapshots may be reloaded after reinstallation.
4.2 步驟 2:增加 ZooKeeper 緩衝區大小
更新 ZooKeeper 配置 (zk-values.yaml) 以增加最大緩衝區大小:
## ZooKeeper 伺服器的日誌級別。預設為 ERROR。請注意,如果將其設定為 INFO 或 WARN,ReadinessProve 將產生大量日誌
##
logLevel: INFO

## 資料日誌目錄。指定此選項將指示 zookeeper 將事務日誌寫入 dataLogDir 而不是 dataDir。
## 這允許使用專用的日誌設備,並有助於避免日誌記錄和快照之間的競爭。
## 範例:
## dataLogDir: /bitnami/zookeeper/dataLog
##
dataLogDir: ''

## ZooKeeper 進程的預設 JVMFLAGS
##
-Djute.maxbuffer=104857600 # 更新為 100MB,大於錯誤訊息 '86389682',預設為 10MB。-
範例:設定為 100MB,大於損壞快照的大小(約 86MB)
-
預設值通常為 10MB,在這種情況下不足
4.3 步驟 3:重新安裝 ZooKeeper
卸載現有的 ZooKeeper 部署:
helm uninstall -n druid druid-cluster-zk使用更新的配置重新安裝:
helm install -n druid druid-cluster-zk bitnami/zookeeper -f zk-values.yaml等待所有 zookeeper 上線後,您的 druid 資料庫將正常工作,您可以在 druid 儀表板中檢查資料。 ٩(ˊᗜˋ )و
希望這能幫助到您。 ~(~ ̄▽ ̄)~
--------------------------------------------------------------------------------------------------------------------------
Last edit by LiuYuancheng ([email protected]) at 13/04/2026, if you have any problem, please send me a message.

No comment for this article.