
[ CISS-Red_Cluster_Monitor 项目启发的实用指南 ]

项目设计目的 : 本文介绍了一个轻量级的、自托管的服务器/VM集群监控系统,该系统使用 Python、InfluxDB 和 Grafana 构建,专门用于处理安全实验室、CTF 环境、OT 网络或隔离集群的特殊或定制监控需求。您将构建自己的自定义数据收集器和监视器,从您需要的精确来源(无论是 IPMI、网络探针还是应用程序特定的端点)获取指标,而不是依赖于黑盒代理,并将它们推送到安全的本地时序数据库中,并使用自定义仪表板可视化数据。
本文中的实际示例受到了 CISS-Red_Cluster_Monitor 项目的启发,该项目旨在监控用于支持红队网络安全 CTF 竞赛的沙箱集群(400 多个 VM)。为了使设计清晰且可重现,本文围绕四个主要部分展开:
-
核心设计思想 – 整体系统架构,包括代理/获取器模型和通信流程。
-
安全配置选择 – 系统如何设计以防止参与者对代理进行逆向工程或发送虚假指标。
-
技术栈 – 使用的工具 (
Python,InfluxDB,Grafana, etc.) 以及如何安装和配置它们。 -
数据和 UI – 数据如何存储、在仪表板中可视化以及进行汇总或警报(例如,通过 Grafana 和 Telegram)。
# Author:           Yuancheng Liu
# Created:          2026/01/27
# Version:           v_0.2.1
# Copyright:       Copyright (c) 2025 Liu Yuancheng
# License:	   GNU General Public License
1. Introduction
市场上有几种免费或商业工具可用于监控服务器和 VM 集群,例如 PM2,它可以监控物理服务器、docker 或虚拟机中的工作负载、网络延迟和服务运行情况,而只需很少的设置。但有时我们可能有一些特殊或定制的需求,例如:
-
无法在某些特定设备上直接安装代理
-
需要从 IPMI 等来源收集电源和硬件遥测数据,而不是从操作系统级别的代理收集
-
系统必须在完全本地/气隙环境中运行,无法访问互联网
-
需要可视化自定义数据收集和验证逻辑。
基于这些场景和需求,监控系统必须在竞争负载下保持简单可靠,防止篡改或虚假数据注入,可部署在受限的网络环境中,并且易于管理员实时可视化和审计。
1.1 Usage Case Background And Objectives
例如,CISS-Red 第一阶段 CTF 活动需要持续监控多个物理服务器和虚拟机,持续 48 小时,以确保基础设施的稳定性并实现快速事件响应。监控目标是实时跟踪关键指标,包括主机服务器的 CPU 和内存使用率、网络延迟、CTF 挑战 VM 的服务可用性以及用户 SSH 登录活动,并通过集中式、直观的仪表板呈现所有这些信息。每当检测到异常情况时,系统会自动向支持和管理员 Telegram 群组发送警报通知。
2. System Architecture
监控系统采用基于信息获取的代理架构,其中中央监控中心主动从分布式代理拉取数据,而不是让代理将数据向上推送。这种设计选择主要受安全考虑因素的驱动:在 CTF 环境中,参与者可能会尝试对代理代码进行逆向工程或伪造请求以注入虚假指标。通过将所有数据收集置于中央中心的控制之下,可以显着减少可能的攻击面,并有效防止未经授权的数据提交。
从架构的角度来看,该系统遵循一个简单的三层设计,如下所示:
┌──────────────┐         ┌──────────────┐         ┌──────────────┐
│  Physical    │         │  Physical    │         │  Physical    │
│  Server 1    │         │  Server 2    │         │  Server N    │
│  ┌────────┐  │         │  ┌────────┐  │         │  ┌────────┐  │
│  │ Agent  │  │         │  │ Agent  │  │         │  │ Agent  │  │
│  │(Python)│  │         │  │(Python)│  │         │  │(Python)│  │
│  └────────┘  │         │  └────────┘  │         │  └────────┘  │
│      │ Local │         │      │ Local │         │      │ Local │
│      │Storage│         │      │Storage│         │      │Storage│
└──────┼───────┘         └──────┼───────┘         └──────┼───────┘
       └────────────────┬───────┴────────────────────────┘
                        │ HTTP Fetch Requests(Pull Mode)
                        ▼
              ┌──────────────────────────┐
              │  Monitor Hub (Collector) │
              └────────┬─────────────────┘
                       │ Write Metrics
                       ▼
              ┌──────────────────────────────────┐
              │   InfluxDB(Time-Series Database) │
              └────────┬─────────────────────────┘
                       │ Query Data
                       ▼
              ┌──────────────────────────────────────┐
              │    Grafana Dashboard (Visualization) │
└──────────────────────────────────────┘-
Agent Layer – 部署在受监控节点上或连接到受监控节点的几个轻量级 Python 代理,用于收集系统和服务指标。
-
Storage Layer – 一个 InfluxDB 时序数据库,用于高效地存储和查询监控数据。
-
Visualization Layer – 一个 Grafana 仪表板,提供集群的实时可视化、历史分析和运营概览,以及一个消息发送器,用于通过 Telegram 消息发送可能的警报。
2.1 System Workflow Detail
整体系统工作流程如下图所示:

在 CISS-Red CTF 环境中,参与者首先通过防火墙 SSH 进入公共 IP 网关,然后访问他们分配的挑战虚拟机。每个托管挑战 VM 或 Docker 容器的物理服务器都配备了两个 RJ45 网络接口,连接到两个隔离的网络:
-
Interface 1 (blue path in the diagram) 专门用于参与者流量以访问挑战服务。
-
Interface 2 (orange path in the diagram) 专用于监控流量,允许监控代理和中心收集运营数据,而不会干扰 CTF 参与者活动或暴露于 CTF 参与者活动。
此配置确保监控流量不会影响竞争环境的性能或公平性。从功能的角度来看,该系统由三个主要组件组成:
-
Service Prober Repository : 一个可重用的 python 服务检查库,提供多种探测功能(例如,NTP、FTP、VNC、SSH 和自定义服务检查)。这些探测器用于验证集群中的特定节点、服务、程序或功能是否正常运行。
-
Prober Agent : 一个轻量级代理,负责调度和执行不同的探测器,以评估集群中一个或多个目标的可用性和运行状况。该代理可以在服务器上本地运行以直接收集指标。对于无法安装代理的节点,系统会退回到基于 SSH 的命令执行来远程检索所需的数据。
-
Monitor Hub : 中央监控和分析组件,提供数据库后端 (InfluxDB) 用于存档时序指标,提供基于 Web 的仪表板 (Grafana) 用于实时和历史可视化,以及用于集成自定义逻辑的可扩展接口,例如分数计算公式或特定于竞争的评估函数。
2.2 Technology Stack
此项目中使用的库和工具以及相关链接如下表所示:
| Component | Technology | Version | Purpose | Link |
|---|---|---|---|---|
| Programming Language | Python | 3.7.4+ | Agent development | |
| Time-Series Database | InfluxDB | 1.8.10 | Metric storage | https://docs.influxdata.com/influxdb/v1/about_the_project/release-notes/ |
| Visualization Platform | Grafana | Latest | Dashboard creation | https://grafana.com/ |
| System Monitoring | psutil | Latest | CPU/RAM metrics | |
| Network Testing | pythonping | Latest | Latency measurement | |
| Time Synchronization | ntplib | Latest | Timestamp accuracy | |
| Telegram API | Telegram Bot | Latest | Real time alert message | https://www.toptal.com/developers/python/telegram-bot-tutorial-python |
3. System Modules Design
本节介绍监控系统的三个核心组件的详细设计:服务探测器存储库、探测器代理和监控中心。
3.1 Service Prober Repository Design
服务探测器存储库是一个可重用的 python 探测库,提供各种功能来检查服务、程序和系统资源的状态,然后插入到探测器代理中。所有探测功能都设计为模块化组件,可以分为三类:local service probers, child agent probers, and network service probers.
3.1.1 Local Service Probers
本地服务探测器直接在目标节点上运行,并专注于监控节点的内部状态,包括:
-
系统资源使用情况(CPU、内存、磁盘、网络 I/O),
-
用户活动(登录会话、命令执行、文件系统更改),
-
本地程序和进程状态(进程生命周期、服务端口、日志状态)。
主要的本地探测器总结如下:
| Prober Name | Probe Action / Coverage |
|---|---|
| Resource Usage Prober | CPU %, memory %, disk usage %, network bandwidth usage |
| User Action Prober | User login, command execution, file system modification |
| Program Action Prober | Process execution, service startup, port status, log checking |
3.1.2 Child Agent Prober
子代理探测器用于从其他探测器代理获取和聚合数据,并将结果合并到统一视图中。这种机制在分段网络环境中特别有用,在这些环境中,某些子网只能通过跳转主机访问,并且没有直接路由可用。通过将代理链接在一起,系统可以桥接隔离的网络段,而无需更改现有的路由配置。
3.1.3 Network Service Probers
网络服务探测器在目标节点外部运行,并验证网络上的服务可用性和正确性。这些探测器模拟真实的客户端行为,并检查服务是否可访问、响应迅速且按预期运行。
| Prober Name | Probe Action / Coverage |
|---|---|
| Server Active Prober | ICMP (ping), SSH login, RDP, VNC, X11/X11:1-Win |
| Service Ports Prober | Customized Nmap-based port scanning for required services |
| NTP Service Prober | NTP latency and time offset correctness |
| DNS/NS Service Prober | DNS name resolution correctness |
| DHCP Service Prober | DHCP broadcast and response check |
| FTP Service Prober | FTP login and directory listing |
| HTTP/HTTPS Web Prober | Web service request/response correctness |
| Email Service Prober | Basic email service availability check |
| TCP/UDP Service Prober | Generic TCP/UDP service connectivity (e.g., Teams, Skype-like services) |
| Database Service Prober | Database connectivity and basic query checks |
这些探测器共同提供了对基础设施运行状况和应用程序级别服务可用性的全面覆盖。
3.2 Prober Agent Module Design
探测器代理负责根据自定义配置配置文件收集、调度和执行不同的探测器。每个代理可以监控单个节点或多个目标,具体取决于部署需求。整体工作流程如下图所示。
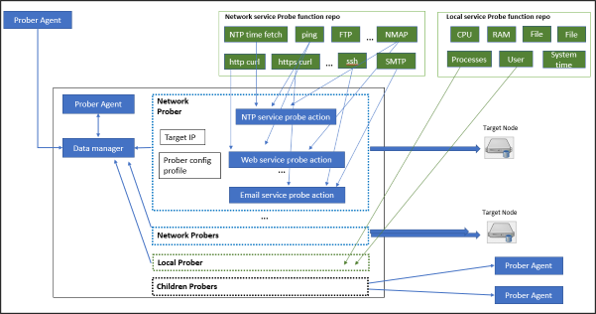
探测器代理提供以下五个关键功能:
-
Profile-Based Configuration : 用户可以定义自定义配置文件来控制运行哪些探测器、它们的执行间隔以及它们的目标范围,从而使监控行为易于适应不同的环境。
-
Inside/Outside Probing : 代理可以在关键节点内部运行以检查本地系统状态,也可以在外部运行以探测多个节点的服务接口。这允许灵活部署,而无需在每个节点上都安装代理。
-
Custom Prober Plugins : 系统提供扩展接口,供用户插入自己的自定义探测器,用于特定于应用程序的检查(例如,验证计费服务或竞争评分服务的状态)。
-
Data Relay Bus : 为了避免更改集群的原始网络路由,探测器代理还可以从其他可访问的代理获取数据并充当relay,从而在分段网络中形成数据收集链。
-
Multiple Communication Protocols : 代理支持多种数据获取和报告协议(TCP、UDP、HTTP、HTTPS),以适应网络安全策略和网络演习环境中常见的流量限制。
3.3 Monitor Hub Module Design
监控中心是负责数据摄取、处理、分析和可视化的中央组件。所有探测器代理通过通信管理器将其监控结果报告给中心。然后,中心通过基于 Web 的界面(当前使用 Grafana)存储、处理和呈现数据给管理员。
除了实时仪表板外,监控中心还提供:
-
一个拓扑视图,显示集群服务的在线/离线状态,
-
以及一个用于集成自定义评分或评估函数的扩展接口,这在 CTF 或网络演习场景中特别有用。
数据流架构如下图所示:

系统中使用两个数据库:
-
Raw Info Database : 存储来自探测器代理的所有收集的原始监控数据,用于审计、分析和历史参考。
-
State Database : 存储经过处理和聚合的数据,这些数据直接用于可视化和状态显示。
Data Manager 组件从原始信息数据库检索数据,执行处理和分析,应用用户定义的评分函数,然后将结果插入或更新到状态数据库中。这种分离确保了原始数据得到保留,同时保持可视化层快速且专注于有意义的、高级别的指标。
4. Grafana 仪表盘 UI 和 Telegram 警报
为了使监控数据具有可操作性且易于理解,系统使用 Grafana 构建了一组专用的仪表盘,用于不同的操作视图。每个仪表盘都侧重于集群的特定方面,例如整体服务健康状况、物理服务器性能、网络状态或 CTF 挑战环境。历史数据和实时指标都以可视化方式呈现,使管理员能够快速识别趋势、异常和事件。
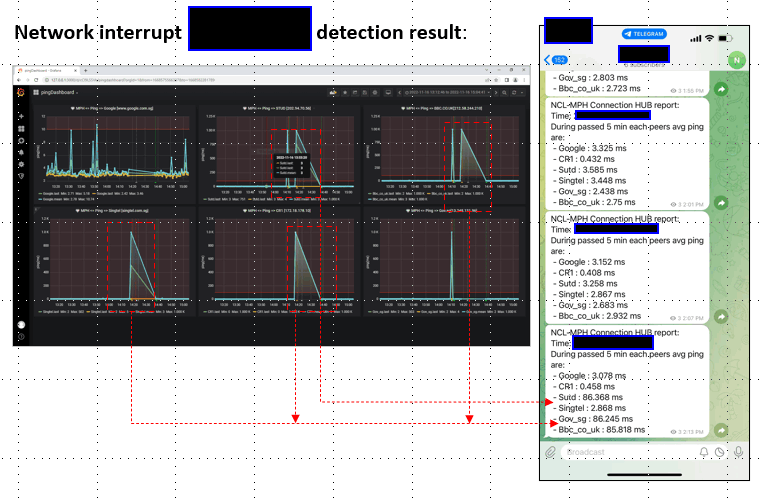
除了仪表盘之外,系统还集成了 Telegram alert mechanism,以便在检测到异常情况(例如,高延迟、服务中断或健康评分降低)时立即通知支持团队。
4.1 集群主状态视图仪表盘
下面的仪表盘用作整个集群的 overview page:
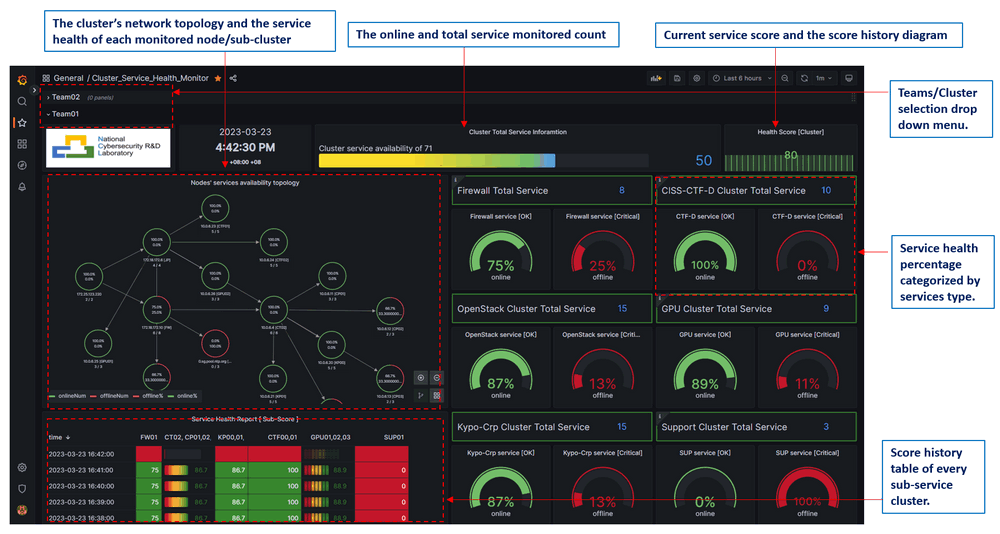
此主页提供了一个高级别的操作快照,包括:
-
集群网络拓扑以及每个受监控的物理服务器/路由器或子集群的服务健康状态,
-
在线挑战服务的数量与受监控的服务总数相比,
-
挑战 Docker 容器、pods 和容器的当前健康评分,以及其历史评分趋势,
-
按服务类型分类的挑战虚拟机服务健康百分比。
4.2 物理服务器集群监控仪表盘
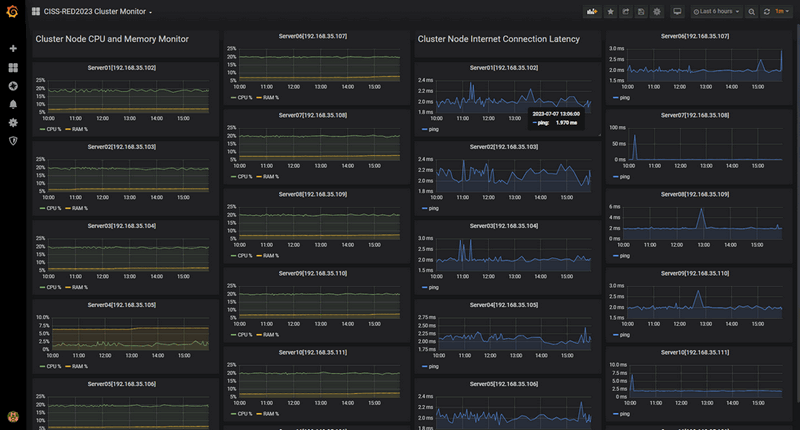
对于每个物理服务器,单击“Physical Cluster Monitor”链接将打开一个详细的性能仪表盘。此页面包含 22 个小图表,排列成四列,如下所示:
-
第 1 列和第 2 列显示物理服务器的 CPU 和 RAM 使用百分比,
-
第 3 列和第 4 列显示网络延迟和带宽使用指标以及相关的网络性能指标。
4.3 集群网络设备和连接仪表盘
为了实现网络级别的可见性,“Network Nodes Monitor Dashboard”提供了对基础设施流量和连接的集中视图。 如下图所示:

通过可视化出站和入站网络连接以及防火墙流量状态,它对于诊断比赛期间的网络瓶颈、错误配置或异常流量模式特别有用。
4.4 CTF 挑战 VM 和 Docker 服务仪表盘
Challenge VM and Docker Service Dashboard 专注于实际的比赛环境(VM、Container 和 Dockers),如下面的示例所示:

技术支持团队通常使用此仪表盘来快速确认特定挑战环境是否正在正确运行或遇到服务降级。它显示了挑战虚拟机、Docker 容器和相关服务的运行时状态和健康状况,以及服务可用性和稳定性指标。
4.5 Telegram 警报通知
除了可视化仪表盘之外,系统还通过 Telegram 提供实时警报。当指标超过配置的阈值时(例如,网络延迟超出可接受的限制,或者服务变得不可用),系统会自动向比赛技术支持组发送警报消息。 示例如下所示:
5. 系统部署和配置
在本节中,我将介绍如何在计算集群环境中部署监控系统,包括代理安装、中心配置、数据库设置和 Grafana 仪表盘集成。
步骤 1:准备每个受监控服务器上的基础设施
首先,确保每个受监控的服务器都安装了正确的时区、Python 环境和所需的依赖项:
sudo timedatectl set-timezone Asia/Singapore
sudo apt update && sudo apt install python3 python3-pip -y
sudo pip3 install influxdb pythonping ntplib psutil --break-system-package
注意:根据您的操作系统和安全策略调整时区和软件包安装方法。
步骤 2:在监控和受监控节点上部署代理
在每个受监控的服务器(或指定的探测节点)上,克隆项目并配置代理:
# On each monitored server
mkdir -p ~/monitorAgent
cd ~/monitorAgent
git clone https://github.com/LiuYuancheng/CISSRed_Cluster_Monitor.git
cd CISSRed_Cluster_Monitor/src/client/
# Configure agent
cp config.template.json config.json
vim config.json  # Edit configuration
# Start agent
sudo nohup python3 AgentRun.py > agent.log 2>&1 &
代理配置文件的简化示例如下所示:
{
  "agent": {
    "hostname": "server1",
    "collection_interval": 60,
    "http_port": 8080,
    "log_level": "INFO",
    "log_file": "/var/log/monitoring/agent.log"
  },
  "metrics": {
    "system": {
      "enabled": true,
      "collect_cpu": true,
      "collect_memory": true,
      "collect_disk": false
    },
    "network": {
      "enabled": true,
      "ping_targets": [
        "192.168.1.1",
        "192.168.1.254"
      ],
      "ping_count": 4,
      "ping_interval": 60
    }
  },
  "storage": {
    "local_cache_size": 1000,
    "cache_directory": "./metrics_cache"
  },
  "time": {
    "ntp_server": "pool.ntp.org",
    "sync_interval": 3600
  }
}
步骤 3:配置并启动 Monitor Hub
在中央监控服务器上,配置代理端点列表:
# On central monitoring server
cd ~/monitorAgent/CISSRed_Cluster_Monitor/src/hub/
# Configure agent endpoints
vim agents.json
# Example agents.json
[
  {
    "hostname": "server1",
    "url": "http://xxx.xxx.xxx.xxx:8080",
    "tags": {
      "role": "compute",
      "location": "rack1"
    }
  },
  {
    "hostname": "server2",
    "url": "http://xxx.xxx.xxx.xxx:8080",
    "tags": {
      "role": "compute",
      "location": "rack1"
    }
  }
]
# Start monitor hub
python3 MonitorHub.py
步骤 4:安装 InfluxDB 并验证数据收集
安装 InfluxDB_1.8.10 并创建所需的数据库(例如,monitorDB)后,验证数据是否正在正确写入:
influx
USE monitorDB
SHOW MEASUREMENTS
SELECT * FROM system_metrics LIMIT 10
如果列出了测量结果并且查询返回数据,则从代理到数据库的数据管道工作正常。
步骤 5:导入 Grafana 仪表盘并配置 InfluxDB 数据源
-
安装 Grafana 并通过以下网址访问 Web 界面:
http://:3000 -
使用管理员凭据登录。
-
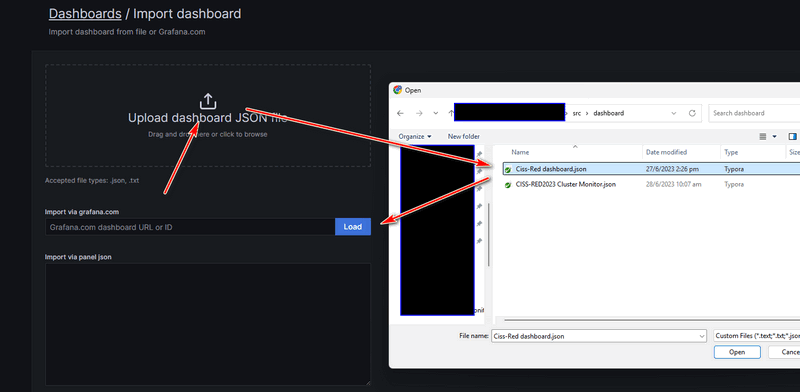
导航到 Dashboards → Import,然后上传仪表盘 JSON 文件(或使用仪表盘 ID 导入):
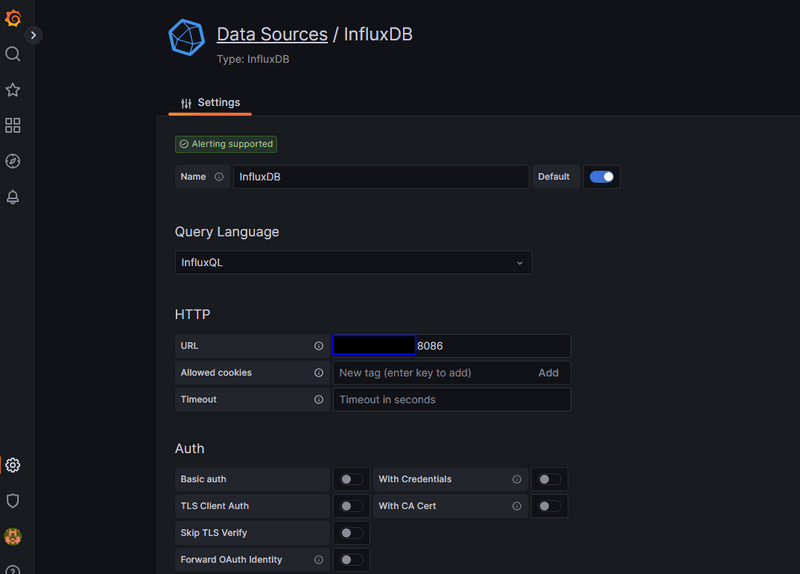
转到 Settings → Data Sources,创建一个新的 InfluxDB 数据源,然后填写数据库服务器 IP 和凭据,如下所示:
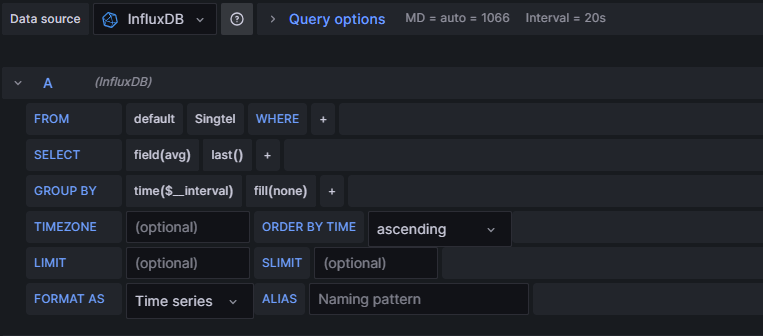
验证所有面板是否正确显示数据。如果面板显示 “No data”,如下所示:

检查每个代理是否正在运行且可访问,验证是否在面板设置中选择了正确的数据源:
您还可以手动插入测试数据,以验证 InfluxDB 和 Grafana 是否正常工作:
InfluxDB shell version: 1.8.10
> SHOW MEASUREMENTS ON monitorDB
> SHOW MEASUREMENTS ON gatewayDB
> USE monitorDB
Using database monitorDB
> SHOW MEASUREMENTS
> INSERT cpu,host=serverA value=10
> SHOW MEASUREMENTS
完成这些步骤后,集群监控系统即可完全运行,并可以为您的基础设施提供实时可见性和警报。
如果您对使用该模块感兴趣,可以参考以下存储库:
- https://github.com/LiuYuancheng/Cluster_Service_Health_Monitor
- https://github.com/LiuYuancheng/CISSRed_Cluster_Monitor
感谢您花时间查看文章详细信息,如果您有任何问题和建议或发现任何程序错误,请随时给我留言。 非常感谢,如果您能提供一些意见并分享任何改进建议,以便我们能够改进我们的工作〜

No comment for this article.